
robots.txtだけで、AIクローラーを止められますか?
止められません。robots.txtはアクセス認可の仕組みではありません。学習用と検索用の方針を分け、必要な遮断はサーバー側で行います。
robots.txtは1994年に生まれ、2022年9月にIETFがRFC 9309として標準化しました。主要なAIクローラーは、いずれも公式ドキュメントでrobots.txtの尊重を明言しています。対象は、GPTBot、ClaudeBot、Google-Extended、PerplexityBotなどです。
ただし、標準化されていることと、強制力があることは別の問題です。robots.txtは、クローラーが自分でファイルを取得し、自分の意思で従って初めて機能します。サーバー側が技術的に遮断しているわけではありません。
さらに、判定に使うUser-Agentは自己申告の文字列です。送信側が自由に書けるため、「GPTBot」と名乗るリクエストが本物とは限りません。Cloudflareが検証済みボット(Verified Bots)の仕組みを用意しているのは、このためです。IPアドレス帯の照合や、Web Bot Authと呼ぶ暗号署名による検証を使います。
もう一つ見落としやすいのが、利用者の代理で動くボットです。ChatGPT-User、Claude-User、Perplexity-Userがその例です。利用者が質問した瞬間に、ページを取得します。OpenAIは、この種のリクエストにはrobots.txtのルールが適用されない場合があると明記しています。
Anthropicは、3種のボットすべてがrobots.txtを尊重するとしています。同時に、IPアドレスでのブロックには注意が必要だとしています。robots.txtを読む能力を妨げるため、適切または永続的に機能しない場合があるためです。
RFC 9309は、robots.txtの規則をアクセス認可の仕組みではないと明記します。悪意あるクローラーや、指示を無視するクローラーを止めるには、別の仕組みが必要です。ネットワークやサーバー側で、技術的に強制します。
学習利用と検索で見つけてもらうことを、別の判断にします。公開情報を広く読んでほしい会社と、会員向けコンテンツを守る会社では、許可する対象が異なります。検索用を止める場合は流入への影響をログで確かめます。
AIクローラーの制御は、どんな手順で進めますか?
現状把握、方針決定、設定、検証の4つを、影響範囲を確認しながら段階的に進めます。
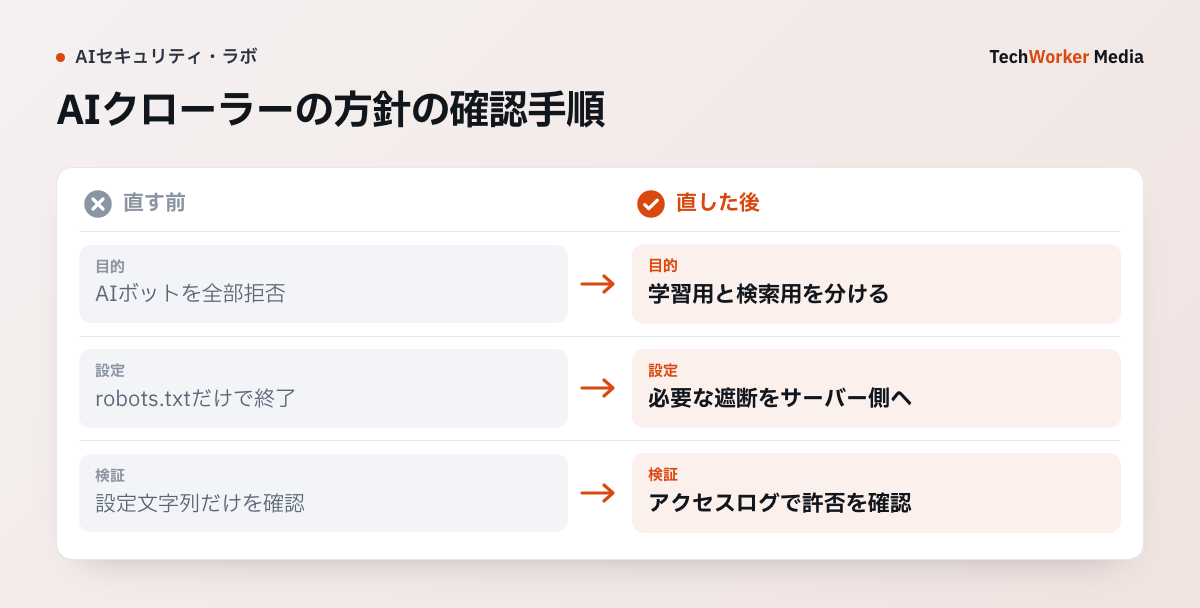
- 現状を把握します。既存のrobots.txtを棚卸しします。Cloudflareを使っているなら、AI Crawl Controlのダッシュボードを開きます。どのクローラーがどれだけアクセスしているかを確認します。意図せず許可・ブロックされているクローラーがないかも見ます。
- 方針を決めます。次の3つの軸を分けて、情シス・広報・Web担当・経営で合意を取ります。
- 学習利用への抵抗感:無断でモデルの学習データにされることに、コンプライアンス・著作権・競争優位の面で抵抗があるか。
- AI検索・AI回答からの流入価値:ChatGPT検索、Perplexity、Gemini経由の参照を、集客に使うか。
- コンテンツの性質:広告収益のページか、会員限定・有償か、採用情報やプレスリリースのように広く読まれてほしいページか。
- 設定します。robots.txtを整えます。Cloudflareを使っているなら、AI Crawl Controlで設定します。クローラーごとに、許可とブロックを設定します。必要に応じて、Super Bot Fight ModeやAI Labyrinthを併用します。全体ブロックになっていないかを確認します。
- 検証します。設定後は、アクセスログで反映を確認します。AI Crawl Controlの遵守状況の追跡機能で、指示に従わないクローラーがいないかも見ます。いれば、Bot ManagementやWAF側での遮断に切り替えます。
手順3の設定例を示します。robots.txtで、学習用は拒否し、検索用とユーザー代理用は許可する書き方です。
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /
編集部による記載例です。Cloudflareの実画面や自動生成結果ではありません。クローラーの最新のトークンは、提供元の公式資料で確認してください。
CloudflareのAI Crawl Controlは、全プランでクローラーのアクセス状況、個別の許可・ブロック、robots.txtへの遵守状況を確認できます。2026年10月3日に公式の概要と管理手順を再確認しました。料金を得るPay Per Crawlは非公開ベータで、通常の遮断機能と分けて扱います。
設定例では、学習用のGPTBotと検索用のOAI-SearchBotを別に指定します。設定文字列だけで送信元の本人性は確認できません。User-Agentの条件と、提供元の公式IP情報や利用するCDNのボット判定を照合します。機微な情報をrobots.txtだけで守らず、認証された領域へ移してください。
AIクローラー対策がうまくいかない例には、どんなものがありますか?
robots.txtだけで終える、一律にブロックする、設定して放置する、の3つが典型です。
- 「robots.txtを書いたので終わり」と報告する。施錠の働きはなく、張り紙と同じです。指示を読んで無視するクローラー、読みに来ないクローラーには効果がありません。
- 全部まとめてAIボットを止める。学習用と検索用は別のボットです。一括ブロックは、AI検索からの露出まで閉じます。「学習させない」ことと「AIの回答に載らない」ことは、同じではありません。
- User-Agentをバージョンまで固定して判定する。実際のUser-Agentには、「GPTBot/1.x」のようにバージョン番号が付きます。この番号は各社のアップデートで変わります。WAFのルールでは、トークン部分を含むかどうかで判定するのが安全です。OpenAIは、送信元IPアドレスの一覧もJSONで公開しています。
- 公開範囲を棚卸ししない。検索エンジンにも出したくない機微な情報が、一般公開領域に置かれている場合があります。方針を決める前に、公開範囲を棚卸しします。この視点は、情シス審査を通すSaaS設計とも重なります。
- 設定して終わりにする。新しいAIクローラーは増え続け、既存のクローラーもポリシーを変えます。四半期に一度など頻度を決め、主要クローラーの動向とアクセスログを見直します。
Web Bot Authのような暗号鍵ベースの検証が広がる前提なら、鍵の管理も設計の対象になります。この点はシークレット管理で扱っています。LLMを使った自社アプリ側の防御は、LLMアプリのガードレールで扱っています。管理画面の防御は、管理画面をVPNなしで守るも参考になります。
主要なAIクローラーは、何をしているのですか?
主要4社は、学習用・検索/回答用・ユーザー代理用でクローラーを使い分けています。
次の表は、各社の公式ドキュメント(2026年8月時点)に基づく整理です。robots.txtの指定には、表内のトークンで足ります。
| 提供元 | クローラー名(robots.txtトークン) | 種別 | 用途 |
|---|---|---|---|
| OpenAI | GPTBot | 学習 | モデル学習用データの収集 |
| OpenAI | OAI-SearchBot | 検索・回答 | ChatGPT検索機能の検索結果への表示 |
| OpenAI | ChatGPT-User | ユーザー代理 | 利用者がChatGPT等で質問した際のその場でのアクセス |
| Anthropic | ClaudeBot | 学習 | モデル学習用データの収集 |
| Anthropic | Claude-SearchBot | 検索・回答 | 検索結果の品質向上のための分析 |
| Anthropic | Claude-User | ユーザー代理 | 利用者がClaudeに質問した際のその場でのアクセス |
| Google-Extended | 学習 | Gemini Apps・Vertex AI向けモデルの学習・グラウンディング | |
| Perplexity | PerplexityBot | 検索・回答 | 検索結果への表示(学習データ収集には不使用と明記) |
| Perplexity | Perplexity-User | ユーザー代理 | 利用者がPerplexityに質問した際のその場でのアクセス |
Google-Extendedは、Googlebotとは別のトークンです。Google検索のインデックス作成やランキングには関与しません。ブロックしても検索順位には影響しないと、Google自身が公式ドキュメントで明記しています。
学習利用だけを止めたいなら、GPTBot・ClaudeBot・Google-Extendedをブロックします。検索・回答用とユーザー代理用のクローラーは許可します。この切り分けは、Search・Agent・Trainingの3分類で、そのまま扱えます。
よくある質問
RFC 9309が示すrobots.txtはアクセス認可の仕組みではありません。技術的に取得を拒否するには、サーバー側の認証や遮断が必要です。法的な効力は、国・契約・利用状況で異なるため、技術仕様だけから一律に断定しません。
robots.txtは、Cloudflareを使わなくても設置できます。自社サーバーに設置するだけで、意思表示ができます。ただし「お願い」止まりである点は変わりません。実効性を持たせるには、自社のWebサーバーやCDN側でUser-Agent・IPアドレスによるアクセス制御を組みます。Cloudflare以外のボット対策製品を組み合わせる方法もあります。
クローラーを区別せず一律にブロックした場合は、そうなります。ただし主要各社は、学習用と検索・回答用でクローラーを分けています。例は、OpenAIのGPTBotとOAI-SearchBotです。AnthropicのClaudeBotとClaude-SearchBotも同様です。学習用だけを止めて、検索・回答用は許可できます。Google-Extendedをブロックしても、通常のGoogle検索の掲載順位には影響しないと公式に明記されています。
いいえ。新しいAIクローラーは今後も増えますし、既存クローラーのUser-Agentや各社のポリシーも変わっていきます。robots.txtに従わないクローラーがいないかを、定期的にログで確認します。Cloudflareを使っているなら、AI Crawl Controlの遵守状況の追跡機能が使えます。実際の状況を定点観測する運用が欠かせません。
次の一歩は何から始めればよいですか?
まずアクセスしているクローラーを把握し、学習と検索で方針を分けてから設定します。
- robots.txtを棚卸しし、どのクローラーが来ているかを確認します。
- 学習利用、AI検索の流入価値、ページの性質の3軸で方針を決めます。
- 決めた方針に沿って許可・ブロックを設定し、実際のアクセスログで反映を確認します。
少なくとも学習用クローラーの扱いは、会社としての方針を持っておく必要があります。四半期に一度などの見直しを、運用に組み込んでください。
この記事は、どの資料をもとにしていますか?
2026年10月3日に上記3資料を確認しました。主要各社のボット表は2026年8月に確認した既存の掲載情報で、全社の最新仕様を今回再検証したものではありません。設定前に対象ボットの公式資料を確認してください。