AIの利用費を見直すには、どの作業にいくらかかったかを、やり直しの回数や成果物の品質と一緒に記録します。その基礎になるのが、入力・出力の処理量を表すトークン数です。まず、公式資料で内訳の数え方を確かめ、自社の作業記録へつなげます。
一次資料:OpenAIの利用量の記録方法(確認:2026年10月6日)
Cached tokens are included in input_tokens, and reasoning tokens are included in output_tokens.
出典:OpenAI, Observability and usage。キャッシュ済みの入力は入力トークン数に、推論で使った分は出力トークン数に含まれます。内訳を合計へもう一度足さないようにします。
公式の利用量項目を二重加算しない
OpenAIの利用量では、キャッシュ済み入力は入力トークンの内訳で、推論は出力トークンの内訳です。総量へもう一度足すと、利用量を過大に報告します。補助エージェントのモデル呼出し、再試行、ウェブ検索、サンドボックスの実行時間、第三者ツール費用は別に確認します。
この利用量は最善努力で記録され、未確認時はnullになり、会計情報の到着後に件数が変わる場合があります。欠損を0件として扱わず、確定費用は提供事業者の利用量・請求記録と照合します。
Anthropicも、推論トークンは出力として課金され、max_tokensは思考と回答を合わせた上限だと説明しています。見えている文章量だけでは費用を判断できません。
作業単位で品質と費用を同じ表に置く
月次総額だけでは削る場所が分かりません。作業種別、モデル、推論強度、入力、キャッシュ済み入力、出力、ツール回数、成功・手戻りを1行にします。品質条件が違う作業は同じ群で比較しません。
費用だけ下がり、手戻りが増えた変更は採用しません。人による確認や再実行に使った時間も、運用コストとして残します。
作業開始前に、モデル呼出し回数、入力・出力トークン、ツール回数、金額または時間の上限を仮置きします。上限へ達したら未完了点を返し、人が追加予算を判断します。品質を優先する仕事でも、上限超過を自動継続しません。
実施記録から分かる項目だけを埋める
次の表は、TechWorkerの2026年10月6日のCodex改修を、この記事用にまとめた記入例です。公開時の検証記録で分かる項目だけを埋めています。
表が画面に収まらない場合は、横にスクロールできます。
| 記録する項目 | 今回確認できる値 | 比較するときの扱い |
|---|---|---|
| 作業と範囲 | Codexによる自社メディア55記事の改稿 | 同程度の原稿量・変更範囲・完了条件を持つ作業だけを比較 |
| 検査結果 | 公開した55記事と原稿の本文が一致 | 記事の構造・画像・リンクの検査も通した条件を残す |
| 手戻り | 公開前にヘッダーが欠けた12記事を修復 | 12は記事数。修正回数や所要時間へ読み替えない |
| 入力・出力・モデル別利用量 | この記録では未取得 | 空欄またはnullで保持し、0にしない |
| 作業時間・請求額 | この記録では未集計 | 速度・費用の改善率やモデルの優劣を算出しない |
作業記録のCSVひな型をダウンロードできます。ひな型は空欄です。実行したモデル・版・設定を確かめ、作業範囲と品質条件を決めてから使います。設定の既定値だけで、実行モデルを埋めないでください。
サブスクリプションの支払額、実際のAPI請求額、API単価による参考換算額は別の欄へ記録します。Claude CodeのTechWorkerの利用記録でも、API換算額と実際の支払いを分けています。製品間の比較は、これらの区別と品質条件がそろってから行います。
惜しまず使う仕事と絞る仕事を分ける
難しい仕事に、追加の原文・推論・検証を惜しまず使う考え方を、トークンマキシングと呼ぶことがあります。統一された用語ではありません。ここでは、使う量でなく、品質が費用を上回る仕事かどうかで分けます。
難しい判断では、入力、推論、出力の上限を早く絞りすぎません。長い資料の突合、複数段階のツール利用、失敗コストの高いレビューでは、思考と回答が途中で切れない上限を与えます。
一方、形式が固定された抽出や整形は、小さいモデルと低い推論強度で足ります。多く使うこと自体を品質指標にはしません。stop_reason、欠落、誤り、手戻りで判断します。
キャッシュ・文脈・モデルをこの順で見直す
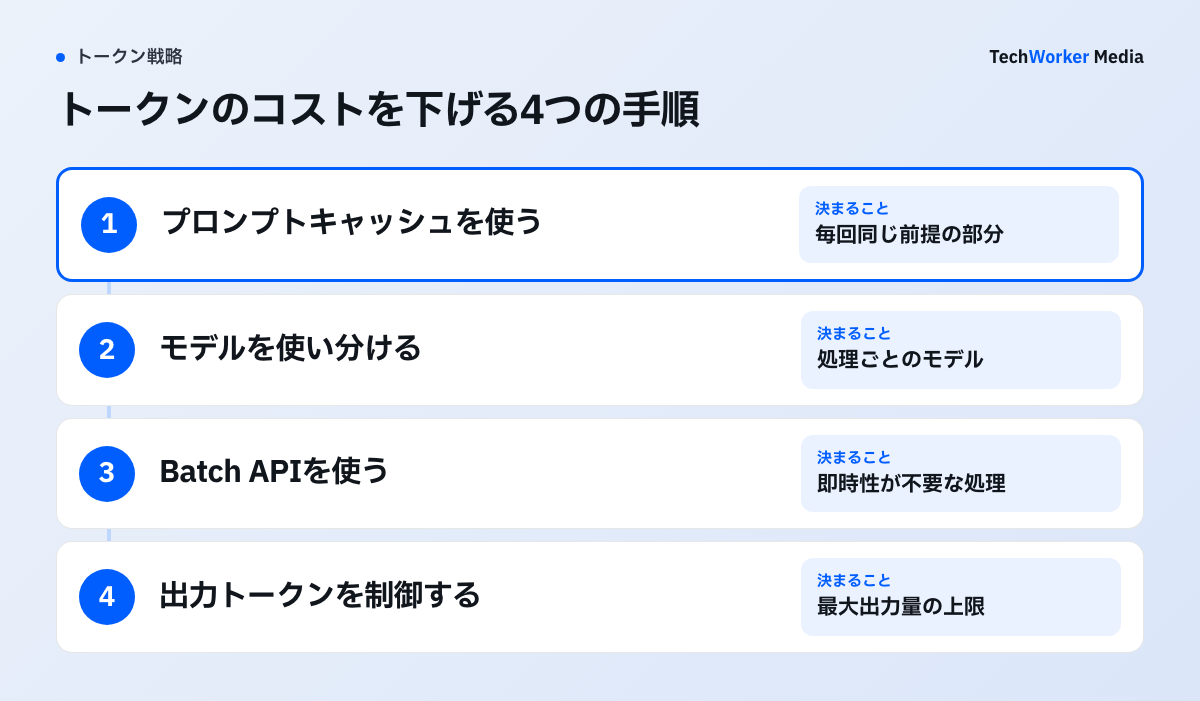
同じ長い共通冒頭を繰り返すなら入力文のキャッシュを使います。次に、毎回送る履歴とツール形式から不要な部分を外します。それでも同じ品質が出る作業だけ、モデルや推論強度を下げます。
価格表は更新されます。記事へ固定額を写す場合は、提供事業者、モデル、処理区分、文脈長、確認日を同時に表示します。単価未確認のモデルは概算しません。