社内に熟練者を置けない、外部モデレーターの日程が合わない、それでも翌月までに実査したい場合、AIモデレーターが候補になります。本記事では、AIと人を分ける3つの軸と実施パターンを示します。
公開済み実画面:CoeSignalリサーチチャット(2026年10月6日確認)
AIモデレーターと人の役割分担
進行と追質問をAIへ任せ、人とは3つの軸で分担して使います。
モデレーターは、定性調査でインタビューを進める役です。質問を投げ、答えを聞き、掘るべき所を判断して聞き返し、限られた時間で論点を回収します。深掘りの質を決める中核の役割です。
ここでいうAIモデレーターは、進行役をAIが担う仕組みです。回答を理解したうえで、「それはどんな場面でしたか」「なぜそう感じたのですか」と、内容に応じてその場で聞き返します。要点は3つです。
- 本質は、回答に反応して掘ることです。台本の読み上げや分岐フォームとは違います。
- 人との関係は分担です。AIは同時並行の実査と共通ガイドの適用、人は非言語の観察・関係構築・その場の仮説の組み替えを担います。AIの追問品質は人が検品します。
- 使い分けは3軸で決まります。調査目的、対象者、深掘りの深さです。
分岐フォームは、作り手が用意した選択肢と分岐しかたどれません。一方、生成型の聞き手は想定外の答えに含まれる言葉を拾い、追加で質問できます。どこまで掘れたかは回答ごとに検品します。
図:分岐フォームとAIモデレーターの違い(※やり取りは説明用のサンプル)。
実装の形は2つあります。非同期型は、回答者がURLを開き、都合のよい時間に声やテキストで答える形式です。AIが一問ずつ聞き返します。リアルタイム対話型は、音声通話のようにその場で対話する形式です。非同期型は日程調整を減らし、回答者が自分のペースで答えられます。どちらが主流かを示す一次資料は確認できないため、目的と対象者で選びます。
AIモデレーターにできること
- 同時並行・24時間の実査。人は1対1で逐次にしか聞けません。AIは複数の回答者と同時に対話できます。非同期なら、日程調整そのものが消えます。
- 共通ガイドを指定した深掘り。全員へ同じガイドを適用できます。ただし、同じガイドでも実際の追問品質はそろうとは限りません。誘導、浅い言い換え、言葉の取り違えを回答ごとに検品します。
- 誘導の抑制。「やっぱり価格ですよね?」と仮説への同意を求める聞き方は、人が無意識にやりがちなミスです。AIへ中立な聞き方を指定し、実際の追問に誘導がないかを確認します。
- 記録の自動化。回答は音声とテキストの両方で残り、録音からの文字起こしの初稿を作れます。誤認識と引用の確認は残ります。
要点は、回答に反応して追加質問することです。反応しない自動質問は、形式がチャットでも中身はアンケートと同じです。
CoeSignalの実査で人に残る工程
URLを配って声かテキストで答えてもらいます。日程調整は不要で、1回10〜20分で実施します。
CoeSignal(株式会社TechWorkerが提供するAIインタビュープラットフォーム)は、AIモデレーターによる実査をURL配布で行います。ファネル型の前段として使える形です。
- 回答方法:声とテキストのどちらでも答えられます。日程調整は不要で、スマートフォンからも回答できます。
- 所要時間:1回10〜20分です。
- 聞き方:3つのモードから、調査目的に合わせて選べます。自然な会話モードは、相槌と追い質問を挟みます。じっくり回答モードは、考える間を回答者が自分で取れます。操作しながら回答モードは、PC画面を共有しながら答えます。
- 成果物:結論と反対意見をまとめた報告書、回答全文の共有画面、報告会です。報告会の所要時間は案件条件で確認します。後段で人が深掘りする対象を選ぶ材料が揃います。
- 対象者:自社の顧客リストへの配布のほか、あてがない場合は、提携する調査ネットワークから条件に合う回答者を募集できます。
料金は、対象範囲・人数・条件・成果物により個別見積りです。30分の無料相談で概算を確認できます。
目的・対象者・深さで調査を組む
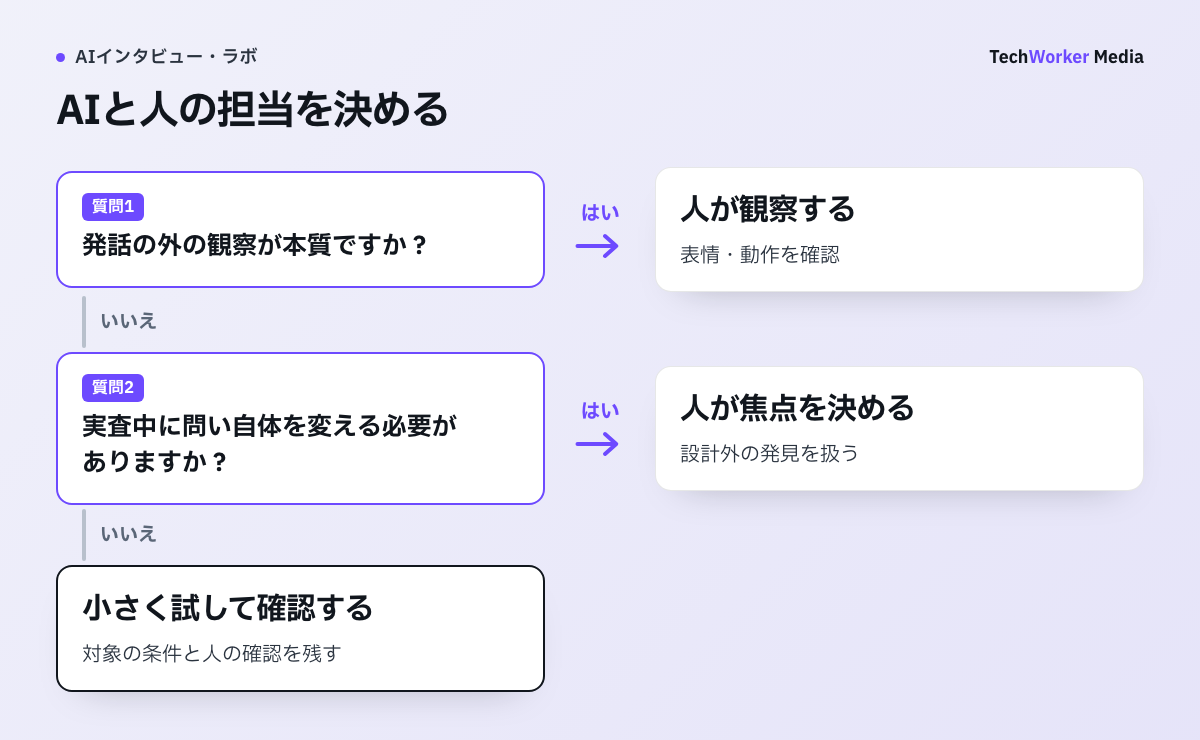
3つの問いで型を決め、場面ごとの推奨を確認し、ハイブリッドを設計して、質問ガイドに時間を回します。
全員に同じ深掘り基準を指定できることと、全員の追問が同じ質になることは別です。パイロットでは、誘導した聞き返し、浅い言い換え、回答者の言葉を取り違えた追問がないかを見ます。人数が多いだけでAIへ決めず、観察とその場の焦点変更が必要かを先に確認してください。
手順1:3つの問いで、AI・人・ハイブリッドを決める
- 人の実査時間と日程調整が許容範囲を超えるか。1件の所要時間、対象人数、担当人数から必要稼働を計算し、許容範囲を超えるならAIの同時並行を試す候補です。人数の考え方はインタビューは何人にすべきかで扱っています。
- 発話の外の情報が本質か。表情・沈黙・手元の操作が主役なら人です。語られる言葉が主役なら、AIによる聞き取りを試験する候補になります。
- 設計の外に出る判断が必要か。聞くべきことを事前に設計できるならAIです。インタビュー中に調査の焦点自体を動かす可能性が高いなら、人です。
手順2:場面ごとの推奨を確認する
- 「なぜ」の仮説を広く集める探索(顧客・想定顧客の数十人)は、AIモデレーターです。
- コンセプト・訴求の反応と理由の収集(想定顧客の数十人)は、AIモデレーターです。
- 解約理由やVoC(顧客の声)の継続的な収集(解約者・既存顧客の多数)は、AIモデレーターです。
- 繊細なテーマの当事者インタビュー(当事者の少数)は、人間モデレーターです。
- エキスパート・キーパーソンへの取材(専門家の数名)は、人間モデレーターです。
- 操作観察を伴うユーザビリティテスト(ユーザーの少数)は、人間モデレーターです。発話より行動の観察が主役になります。
- 広く聞いてから重要な相手に深く聞く調査は、ハイブリッドです。
手順3:ハイブリッドの型を選ぶ
実務の最適解は、多くの場合、組み合わせです。世界最大級の調査会社イプソスは、2025年12月の公式記事(Mind or Machines: Exploring AI moderation and when to use it)で、ハイブリッドモデルを提唱しました。考え方は「人と機械(mind and machines)」で、AIを共同モデレーター(co-moderator)に位置づけます。
同記事は、AIを共同モデレーターとし、人の専門家が設計と結論を担う方法を示しています。出典:Ipsos「Mind or Machines」(2025年12月8日)。確認日:2026年10月3日。
組み合わせ方は、次の3パターンに集約されます。
- ファネル型(AI→人):AIで数十人に広く聞いて論点を絞り、重要な論点を語った数名に人が深く聞きます。探索から始まる調査全般に向く、最も汎用的な基本形です。
- 検証型(人→AI):人の少数デプスで仮説を立て、AIで広い人数に当てて広がりを確かめます。熟練モデレーターの知見が既にあり、規模の裏づけが欲しい場面に向きます。
- 並走型(AI×人の分担):同一調査内で、繊細な対象者やキーパーソンは人が、それ以外はAIが担当します。対象者の属性が混在する、B2Bの顧客調査などに向きます。
最初の一手には、ファネル型を勧めます。動き方は次のとおりです。
図:ファネル型ハイブリッドの流れ(※内容は説明用のイメージ)。人の稼働は最重要の3名分に集中する。
この設計は、人間モデレーターの価値を下げません。AIが前段で論点を絞るので、人の60分は核心を詰める時間になります。稼働は減り、1回あたりの密度は上がります。集めた語りを論点に落とす実務は、インタビュー分析をAIで行うで扱っています。
手順4:質問ガイドの設計に時間を移す
3問すべてがAI寄りでも、設計の作法は人間モデレーター時代と変わりません。質問ガイドの組み方、誘導の排除、パイロットでの磨き込みが必要です。AIモデレーターの質は設計で決まります。浮いた実査時間は、深掘りポイントの指定とパイロットに投資してください。
人へ残すべき4種類の調査
非言語の観察、関係構築、設計外の脱線、グループ運営が主役の調査は、人間モデレーターに残ります。
導入判断を誤らないために、できないことを先に押さえます。次の4つは、AIモデレーターに向きません。
- 非言語情報の観察。表情の曇り、沈黙の長さ、視線、手元の操作を、その場では読み取って解釈できません。
- 関係構築(ラポール)からの聞き取り。病気・家族・金銭トラブルのような繊細なテーマが当てはまります。信頼関係を築いてから核心に入る進行は、熟練した人間モデレーターの領分です。
- 設計を離れた大胆な脱線。回答の一言から「調査の前提が違うのでは」と気づき、その場で焦点を組み替える判断は、AIに任せられません。AIの深掘りは、設計された範囲の中で働きます。
- グループの場の運営。複数人の発言をさばき、対立を引き出し、声の大きい参加者を制御するグループインタビューは、現時点では人の仕事です。
設計にも落とし穴があります。中立な聞き方を指定しても、実際の追問に誘導がないかを確認します。設計に誘導が入れば、その影響が繰り返されるため、質問ガイドと実際の出力を分けて検品します。
置き換える対象は、「実査のオペレーション」です。「何を聞くべきかの判断」は置き換えません。設計と解釈は、人の中核業務として残ります。
人とAIの得意領域を比較する
人は文脈への適応と観察に、AIは一貫性と規模にそれぞれ強く、得意な局面が重なりません。
「AIは人より上か下か」という問いは、実務では役に立ちません。両者は強みの構造が違うからです。観点ごとに比べます。
| 観点 | 人間モデレーター | AIモデレーター |
|---|---|---|
| 同時に聞ける人数 | 1人ずつ逐次 | 複数の回答者と同時並行 |
| 実施時間 | 全員の日程を調整して確保 | 回答者の都合に合わせ24時間 |
| 深掘りの質の源泉 | モデレーター個人の技量と経験 | 質問ガイドと深掘り設計の品質 |
| 品質の一貫性 | 人・日・時間帯でばらつく | 同じ基準を指定し、追問の品質を検品する |
| 非言語情報 | 表情・沈黙・場の空気まで観察 | 発話(音声・テキスト)の範囲まで |
| 関係構築 | ラポールを築いてから核心へ | 関係構築を前提にできない |
| その場の脱線・組み替え | 調査の焦点自体を動かせる | 設計された範囲の中で深掘り |
| 回答者側の心理 | 評価懸念で建前が出る場面がある | 対人の気兼ねが薄れ話しやすい場面がある |
| コスト構造 | 稼働が人数・時間に比例 | 質問進行の稼働を減らせる。募集・検品・分析の稼働は別に確認する |
回答者側の心理の行には補足があります。人に評価される心配が薄れると、対人では言いにくいことを、機械相手には率直に話しやすくなります。この趣旨の研究報告は複数あります。共感の乏しさが語りを浅くする場面も報告されています。
研究の実像と限界は、人はAIに本音を話すのかで掘り下げています。繊細なテーマを扱う方は、あわせて読んでください。
比較表の「深掘りの質の源泉」には補足が要ります。人の実査は、採用・育成だけでなく、質問ガイドと実査後の振り返りで見直します。AIを使う場合も、共通ガイドを更新すれば全員へ同じ変更を適用できますが、追問品質が一律に上がるとは限りません。改訂後もパイロットと回答検品を続けます。
TechWorkerが運用上の利点として重視するのは、共通の質問ガイドを全員へ適用し、改訂内容を次の実査へ反映できる点です。ただし、設計をそろえても出力品質は自動ではそろいません。パイロットで誘導、取り違え、浅い追問の発生率を確認します。
よくある質問
置き換えません。分担して使うのが実務の答えです。AIは同時並行の実査と、共通ガイドを適用できる点に強みがあります。実際の追問品質は検品します。人は非言語情報の観察、関係構築、その場の仮説の組み替えに強みがあります。得意な局面が重なりません。世界最大級の調査会社イプソスも、公式記事でAIを共同モデレーターとするハイブリッドモデルを提唱しています。
話しやすくなる場面があります。人に評価される心配が薄れるため、対人では言いにくいことを率直に話しやすくなるという研究報告があります。金銭や不満のような話題では、機械相手が有利に働くことがあります。共感の乏しさが語りを浅くする場面もあるため、テーマごとの向き不向きの見極めが前提です。詳しくは研究ノート「人はAIに本音を話すのか」で整理しています。
表情・沈黙・手元の操作など、発話の外の情報が主役の調査です。信頼関係の構築から始める繊細なテーマも向きません。専門家を相手に、設計を離れて脱線しながら掘るエキスパートインタビューも同様です。これらは人間モデレーターの領分として残ります。対象人数がごく少なく、一人の語りの重みが大きい調査も当てはまります。
ファネル型が起点です。まずAIモデレーターで数十人に広く聞いて、論点を絞ります。重要な論点を語った数名にだけ、人が深く聞きます。人の稼働を最小にしたまま、広さと深さの両方を確保できます。既存のインタビュー体制を変えずに、前段のAI実査だけを足せる点が利点です。
実査前に決める人とAIの分担
質問ガイドには、AIが続けてよい範囲と、人へ戻す条件を併記します。定型の追加質問、全員への共通質問、同時並行の実査はAIへ置けます。表情の観察、設計外の論点へ焦点を移す判断、センシティブな開示への対応は人が担います。
試験実査では、追質問が問いの目的に沿ったか、同じ論点を繰り返していないか、回答者が中断できたかを原文で確認します。件数を増やすのは、この検品を通した後です。


