AIエージェントのtool呼び出しをJSON schemaで縛ると、壊れたJSONや未定義のenumは減らせます。それでも{"customer_id":"他社のID","amount":0,"recipient":"攻撃者"}のように形式が正しい引数は通ります。schemaは「形」を検査する仕組みであり、その利用者がその顧客を更新できるか、金額が正しいか、今が送信可能な状態かを決める認可・業務ルールではありません。
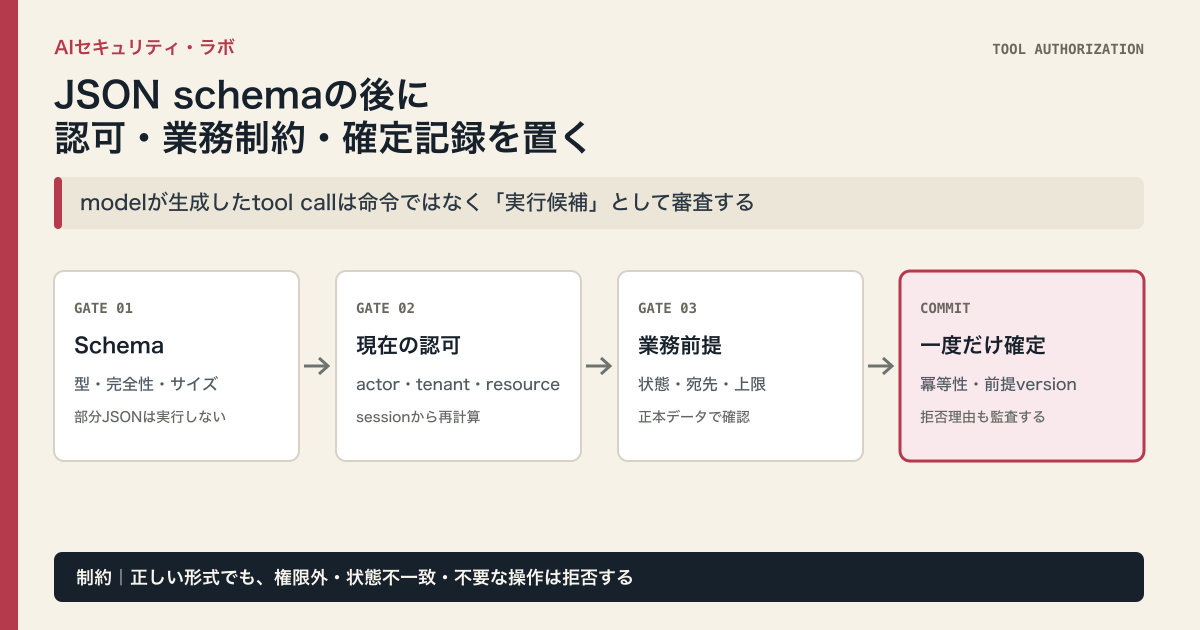
結論は、LLMが作ったtool callを命令として実行せず、候補として四段階で審査することです。schema → 現在の認可 → 業務前提条件 → 一度だけの確定記録に分けます。これは9月12日のレッドチーム記事が「どの攻撃経路を試験するか」を扱ったのに対し、本稿は本番の一呼び出しをどこで拒否するかを扱います。9月1日の承認ゲートとも役割が異なります。人の承認は判断の確認であり、サーバー側の認可を省略する理由にはなりません。
schemaは入口、認可はサーバーの責務
OpenAIのStructured Outputsは、供給したJSON Schemaへの応答適合を目的にし、strict: trueを指定できます。ただし対応するのはJSON Schemaの一部で、拒否やtoken上限による不完全応答もあり得ます。ここで得られるのは、例えばactionが許可enumで、record_idが文字列であるという構文上の保証です。record_idがログイン中の利用者の組織に属するか、actionがその利用者の権限内かは、アプリの認可層が現在のsessionから再計算します。modelが返したrole、tenant、承認済みフラグを、そのまま信用しません。
Anthropicのclient toolも、modelがtool_use blockを返し、アプリケーション側のコードが実行します。これは実行責任がアプリに残る設計です。たとえば「請求書を送る」toolはinvoice_idとrecipientを受けても、サーバーが請求書の所属、宛先ドメイン、利用者の送信権限、未送信状態をデータベースから確認して初めて呼び出します。LLMの説明文やtool descriptionに「管理者だけ」と書いても、認可制御にはなりません。
正しい形でも拒否する、業務上の前提条件
二段目の認可を通っても、実行が正しいとは限りません。そこでtoolごとに、serverが検証できる前提条件を列挙します。送信なら宛先allowlist、添付の分類、利用者の確認、未送信であること。更新なら対象のversion、状態遷移、更新可能なフィールド、上限額。検索ならtenantと保持期限。LLMにはintentや候補値を作らせ、現在の正本データから実際の対象・宛先・金額を決めます。
OWASPの2025版は、LLM出力を下流システムへ渡す前の検証・サニタイズ不足をImproper Output Handlingと呼び、SSRF、権限昇格、コード実行などにつながり得ると整理しています。ここで重要なのは、悪意あるpromptだけが原因ではない点です。曖昧な依頼、古い会話文脈、modelの誤推定でも、業務ルールを飛ばした出力は危険です。出力文字列をエスケープするだけでなく、操作対象をサーバーで引き直す必要があります。
OWASPのExcessive Agencyは、過剰な機能・権限・自律性を原因として挙げています。したがってpolicy adapterだけでなく、tool自体を用途別に狭くし、実行主体へ必要最小限の下流権限だけを与える必要があります。
MCPでは、入力・出力・表示を別々に疑う
MCPのTools仕様は、serverに全tool inputの検証、適切なaccess control、rate limit、tool outputのsanitizationを求め、clientには結果をLLMへ渡す前の検証、監査ログ、機微な操作の確認を勧めています。さらにtool annotationはtrusted server由来でない限りuntrustedとして扱う必要があります。つまりMCPのinputSchemaやoutputSchemaは有用でも、接続先の説明、返ってきた自然言語、modelが選んだ引数を権限の根拠にはできません。
実装では、MCP serverを「認可済みの業務API」に直接つなげず、policy adapterを一枚置くのが最小です。adapterは利用者のsessionからactorとtenantを取得し、schemaを検証し、resourceを再取得し、許可された操作へ狭め、外部効果の前に確認IDまたは冪等性キーを要求します。tool resultには、表示に不要な内部ID、token、例外traceを混ぜず、LLMへ渡す要約と監査用の完全記録を分けます。これにより、tool result内の指示文を次の命令として採用する経路も狭められます。
確定を一度だけにし、拒否も証跡にする
最終段階は、effect(外部効果)を確定する直前です。書込みにはactor_id、resource_id、認可判断の版、前提条件のversion、idempotency keyを結びます。同じkeyで届いた再試行は過去の結果を返し、新たな送信・更新をしません。認可拒否、schema不適合、状態不一致も、秘密情報を残さない範囲で理由コードを記録します。そうすれば「modelが何を言ったか」ではなく、「誰が、どのresourceへ、どのpolicyのもとで、何を試み、どこで止まったか」を後から調べられます。
限界と確認範囲
ただし、この層を増やしてもLLMが業務意図を正しく理解する保証にはなりません。正しい権限で正しい形式の、しかし不要な操作を提案することはあります。高影響操作では、実行前の利用者確認、金額・宛先・変更差分の見える化、権限の最小化を重ねます。承認画面があっても、server側が毎回認可と前提条件を再検証する設計を崩さないでください。
導入時の最小チェックリスト
- model出力のtenant、role、承認済みフラグを認可根拠に使わず、sessionから再取得しているか
- schema通過後に、対象resource、権限、状態遷移、宛先・金額などをserverで確認するか
- tool resultをLLMへ渡す前に、不要な秘密情報と命令扱いされ得る文字列を分けているか
- 書込みに前提versionと冪等性キーを結び、再試行が二重効果を起こさないか
- 拒否を含む判断結果を、本文・tokenを最小化して監査できるか
情報図解
結論: JSON schemaは安全な実行の入口であって、認可の代替ではない。
- 形を検査: schema・完全性・サイズを確認し、不完全なstream中の引数は実行しない。
- 権限と前提を検査: sessionからactorを決め、resourceの所属、操作権限、状態・宛先・上限を正本で確認する。
- 一度だけ確定: 冪等性キーと前提versionを記録して実行し、表示用結果と監査用証跡を分ける。
制約: policy adapterは業務ルールを正しく定義して初めて働く。曖昧な業務権限、古い正本データ、承認者の見落としを自動的には解決しない。
一次根拠
- OpenAI: Structured model outputs
- Anthropic: Tool use with Claude
- Model Context Protocol: Tools specification
- OWASP: LLM05 Improper Output Handling
- OWASP: LLM06 Excessive Agency
- NIST: AI RMF Generative AI Profile
一次情報と確認範囲
確認日:2026年9月13日。製品仕様・制度は更新されるため、導入時はリンク先の最新版を再確認してください。海外の制度・職業規範は日本へ直接適用せず、相違点と限界を本文に明記しています。
- OpenAI Structured Outputsは供給したJSON Schemaへの応答適合を目的とし、`strict: true`を指定できる。一部schema機能は未対応である
- Anthropicのclient toolはmodelが`tool_use` blockを返し、アプリのコードが操作を実行して`tool_result`を返す
- MCP Tools仕様はserverにinput検証・access control・output sanitizationを、clientに結果検証・監査・機微操作の確認を示す
- OWASPはLLM出力の下流利用前の検証・サニタイズ不足をLLM05 Improper Output Handlingとし、SSRF・権限昇格・RCE等の影響を挙げる
- OWASPはAI agentの過剰な機能・権限・自律性をExcessive Agencyの主要因として挙げる
- NISTのGenerative AI Profileは設計、開発、利用、評価のライフサイクルにわたるGenAIリスク管理を扱う