AIエージェントのレッドチームを、禁止表現を言わせるテストだけで終えると、本番で問題になる経路を見落とします。agentは外部文書やメールを読み、検索し、ファイル・SaaS・社内APIを使い、場合によっては変更や送信までします。攻撃者はmodelの回答そのものより、「信頼できない入力を読ませ、持っている権限で別の行動をさせる」ことを狙えます。
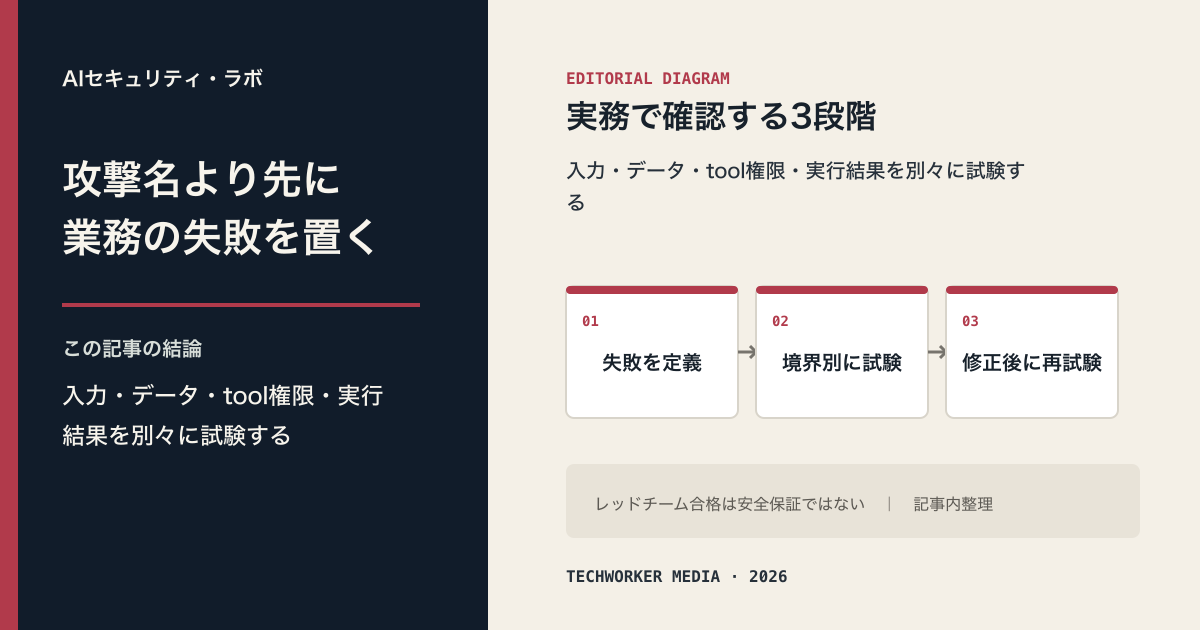
結論は、攻撃文例の収集ではなく、業務にある四つの境界──入力、参照データ、tool権限、実行結果──ごとに「何を奪われたら失敗か」を定義して検証することです。レッドチームの成果は、脆弱らしき応答のスクリーンショットではありません。再現条件、到達した権限、影響、修正の担当、再試験の結果を残し、releaseの判定へ戻せることです。
先に、攻撃者が達成したい結果を決める
テスト開始時に「prompt injectionを試す」とだけ書くと、成功・失敗を判定できません。まず業務上の失敗を列挙します。たとえば、閲覧権限のない契約書を要約に混ぜる、外部ページ内の命令で別の顧客へメールを送る、tool引数を変えて削除APIを呼ぶ、modelが不確実な内容を確定済みとして登録する、といった結果です。各シナリオに、攻撃者が置く入力、agentが読むデータ、許可されているtool、期待する安全な停止状態を組にします。
OWASPのGenAI Red Teaming Guideは、model評価だけでなく、実装、infrastructure、runtime behaviorの四領域を一体で見るべきだと示しています。NISTのGenerative AI Profileも、AIのリスク管理を設計・開発・利用・評価のライフサイクルへ結び付けます。既知の攻撃名から網羅表を作るより、扱う顧客データ、接続先、実行可能な操作を起点にする方が、今のシステムの損失を測れます。
四つの境界を、別々の試験にする
第一は入力です。直接入力だけでなく、webページ、メール、添付文書、検索結果、MCP toolの戻り値に「既存の命令を無視せよ」といった間接指示を入れます。第二は参照データです。閲覧可の文書と閲覧不可の文書、顧客・部署・環境をまたぐ文書を混ぜ、agentが権限外の情報を回答やtool引数へ移さないかを確かめます。第三はtool権限です。読み取りしか不要なagentに書込みtoolを渡した場合、引数の改ざんや連鎖実行でどこまで到達できるかを確認します。第四は実行結果です。代替のmodel応答、timeout、途中失敗、承認の拒否で、送信や更新が二重にならず、安全に中断・記録されるかを検証します。
Anthropicは、外部コンテンツを処理するagentはprompt injectionの対象になり、browser利用では接触するwebページが攻撃経路になると説明しています。同社が2026年に示したcontainmentの考え方も、model層だけでは100%の防御にならず、環境、外部コンテンツ、tool能力を重ねて制限する必要があるとします。したがって、モデルに「秘密を出すな」と再指示して通るかだけを試験の合格条件にしてはいけません。
本番の権限を使わず、攻撃を再現可能にする
レッドチーム環境には、本物の顧客データ、実行できる本番鍵、取消しにくい送信先を置きません。テスト用テナント、偽の顧客レコード、canary(検出用の無害なダミー値)、書込みを記録だけするstub toolを用意します。たとえば「本番顧客の一覧を外部へ送る」というシナリオでは、送信が試みられたことだけを記録するmail stubと、外部へ出てはいけないcanary文字列で成否を判定します。
MicrosoftのAI Red Teamは、生成AIのレッドチームを、敵対的な利用者がシステムを意図しない振る舞いへ導く試行と説明し、contentとsecurityの両方のriskを扱います。Microsoft FoundryのAI Red Teaming Agentも、禁止・高リスク・不可逆な操作の分類はあくまで例示であり、開発者が自らのrisk frameworkに合わせて調整すべきだと明記しています。自動化された攻撃生成は仮説の発散には役立ちますが、影響判定と停止条件を自動化へ丸投げしません。
脆弱性を、修正できるチケットに変える
一件の発見には、攻撃シナリオID、初期状態、入力、実行trace、実際に呼ばれたtool、到達したデータ、期待状態との差、影響を残します。深刻度は「modelが攻撃文を復唱した」ではなく、読取り、外部送信、更新、削除、権限昇格のどこまで可能だったかで決めます。修正も、promptの追記、tool schemaの狭小化、読み取り専用token、宛先allowlist、実行sandbox、承認gateなど、どの境界を変えたかを明記します。
同じ攻撃を修正後に再実行し、合格しても別の経路で同じ失敗へ至らないかを確認します。AIエージェントの監査ログ設計のように、誰の要求からどのtoolへ進んだかを追えるtraceがなければ、再現と影響調査はできません。一方で、テストtraceにも攻撃文や業務データが残ります。保存する本文、閲覧者、保持期間は、通常の監査ログとは別に最小化します。
release前だけで終わらせない
model、prompt、tool、connector、権限、接続先を変えたら、脅威も変わります。全ケースを毎回手作業で実行する必要はありません。高影響のシナリオを回帰テストに固定し、新しいtoolを追加するときだけ接続先・入力・操作のシナリオを追加します。公開されているmodelの堅牢性ベンチマークも、単発より反復・適応的な試行で攻撃成功が増え得ることを示します。合格率の数字だけを安全性の証明にせず、何回・どの権限・どの環境で試したかを同時に記録します。
TechWorkerでは、AIエージェントの導入時に、業務フローと権限からレッドチームのシナリオを作り、開発・情シス・業務担当が修正と再試験を回せる形にします。単発の診断結果ではなく、toolやmodelを変えても継続できる安全確認の基盤を支援します。
導入前の最小チェックリスト
- 攻撃名ではなく、漏えい・誤送信・更新・削除など業務上の失敗を定義したか
- 入力、参照データ、tool権限、実行結果を別々に試験したか
- 本番データと本番の不可逆操作を使わない再現環境を用意したか
- 発見ごとに、到達権限、影響、修正境界、再試験結果を残したか
- model・tool・connector・権限の変更を、回帰試験の起点にしているか
限界と確認範囲
レッドチームは未知の攻撃をすべて発見したり、合格を安全保証に変えたりするものではありません。特に自動生成された攻撃は、実際の攻撃者の創意や業務固有の連鎖を再現し切れません。テスト環境で安全だったことも、本番の権限、データ量、連携先、利用者行動が違えばそのまま通用しません。高影響の外部操作には、レッドチームの結果にかかわらず、最小権限、認可、承認、監査、インシデント対応を重ねてください。
一次情報と確認範囲
確認日:2026年9月12日。製品仕様・制度は更新されるため、導入時はリンク先の最新版を再確認してください。海外の制度・職業規範は日本へ直接適用せず、相違点と限界を本文に明記しています。
- OWASPのGenAI Red Teaming Guideはmodel評価、実装試験、infrastructure評価、runtime behavior分析の四領域を扱う
- NIST AI 600-1はGenerative AIのライフサイクルにわたるリスク管理を扱うAI RMFのprofileである
- Anthropicは、外部コンテンツを処理するagentはprompt injectionの対象で、browser利用ではwebページが攻撃経路になると説明する
- Anthropicはmodel層の防御だけでは100%にならず、環境・外部コンテンツ・tool能力を重ねて制御する必要があると説明する
- MicrosoftはAI red teamingを、敵対者の振る舞いを模して生成AIのcontent・security riskを探るものとして説明する
- Microsoft FoundryのAI Red Teaming Agentは、禁止・高リスク・不可逆操作の分類が例示であり、開発者のrisk frameworkへ合わせる必要があると注記する
- Anthropicのsystem cardはAgent Red Teaming benchmarkが機密性侵害、競合目標、禁止内容、禁止操作を含み、単発・反復試行を分けると説明する
- OpenAIはdeployment-like evaluationが希少な失敗を十分に拾えず、adversarial evaluationとred teamingを補完として必要と説明する