
AIインタビューの声から、感情や本音は推定してよいですか?
声から分かるのは特徴とモデルの推定までです。感情ラベルだけで回答の除外や顧客の順位付けはしません。
AIインタビューの音声から分かるのは、まず音高、強さ、話す速さ、間などの特徴です。「不安」「怒り」「関心が低い」は、その特徴を基にしたモデルの推定です。
さらに「本当は反対している」「うそをついている」と判断すれば、二段階の飛躍になります。声の感情ラベルだけで、回答を除外したり、顧客を順位付けしたりしてはいけません。
EU AI Act(EUのAI規制法)は、声などの生体データから感情や意図を推定する仕組みを、感情認識として扱います。
前文44は、感情表現が文化や状況によって異なり、同じ人でも変化すると説明しています。そのため、信頼性、特異性、一般化可能性に懸念があるとしています。職場と教育機関での感情推定は、医療・安全目的を除いて禁止対象です[1]。
この規定を、日本の市場調査へ一律に当てはめることはできません。日本所在だから対象外と決めることも、できません。
第2条は、EU域外の事業者でも、AIシステムをEU市場へ提供する場合などを、適用範囲に含めます。出力がEU域内で使われる場合も含みます。対象者、出力の利用地、提供形態を、個別に確認してください。適用の有無とは別に、感情ラベルを客観的事実とみなさないための警告として読めます。
要点は3つです。
- 音声から分かるのは音の特徴で、感情ラベルはモデルの推定です。声の推定だけで、回答の除外や顧客の順位付けはしません。
- 観測、モデルの推定、人の判断を別々の欄に残します。本番と同じ日本語や端末、対象者層の音声で受入試験をして、誤りの偏りを確かめます。
- 声には手がかりもありますが、細かな感情名が文化を越えた事実とは限りません。ラベルは、人が音声を確認する順番を決める補助に留めます。
声の感情推定を使うなら、どんな手順で進めればよいですか?
観測・推定・判断を分けて記録し、実査条件で受入試験をし、使える範囲を狭く決めます。
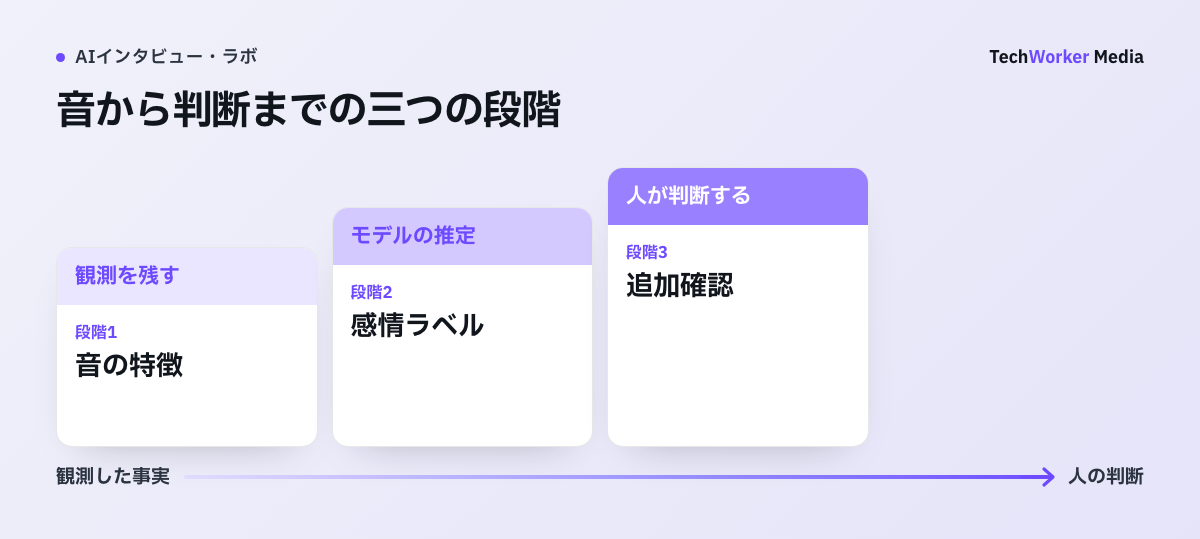
本文の「4秒の無音」と「苦痛の可能性0.7」は、欄の分け方を説明する例です。無音があった事実と、モデルが付けたラベルを同じ事実欄に入れません。回答者の発言と食い違うラベルは上書きせず、両方を確認担当へ渡します。感情名から、本音や虚偽まで確定する工程は設けません。
手順1:観測、推定、判断を三つの欄へ分ける
分析表には、観測した特徴、モデルの推定、人が下した判断を、別々に残します。各欄の例は、後段の表にまとめました。
三つを同じ「感情」列へ入れると、どこで誤ったかを、後から確かめられません。
Hume AIの製品ページは、音声などから複数の表現次元と確信度を返すと説明しています。例として、いら立ち、苦痛、温かさ、関与を挙げています[2]。
多数のラベルが出ることは、本人の内面を直接測れたことを意味しません。提供会社の製品説明は、日本語の実査音声や対象顧客での独立した精度証明でもありません。
モデルラベルと発言内容が食い違った場合は、逐語録を上書きしません。たとえば、モデルが「関心が低い」と出しても、回答者が具体的な利用場面を長く説明しているなら、両方を残します。ラベルは、人が音声を確認する順番を決める補助までに留め、回答の真偽判定には使いません。
手順2:公開精度に頼らず、実査条件で受入試験をする
受入試験には、本番と同じ日本語、対象者層、端末、マイク、通信、周囲雑音を含めます。人が独立に音声を評価し、意見が割れた箇所も保存します。
モデルと人の一致率に加えて、話者群、質問、録音条件ごとの誤りを分けます。平均値が高くても、特定の話者や雑音条件で誤りが集中するなら、その条件では使えません。
Interspeech 2024のEmo-bias研究は、音声感情認識モデルを複数データセットで比べました。性別による性能差と、学習データ構成が偏りへ影響することを報告しています[3]。
同会議のEmoBoxは、14言語・32データセットを共通条件で扱っています。未知の話者や録音条件を評価するには、学習時とは別の音声データ集で試す必要があるとしています[4]。
公開ベンチマーク(性能比較の基準データ)の数字を一つ転記するだけでは、自社のインタビューでの受入試験になりません。
合否は、利用目的ごとに決めます。聞き直す音声の候補を絞る用途と、回答者を除外する用途では、誤りの損失が違います。本記事が勧めるのは、前者です。局所検証がない状態で、採否、人格評価、虚偽判定へ進めないことを、停止条件にします。
手順3:反対方向の証拠も残し、使える範囲を狭く定める
「声からは何も分からない」と決めつけるのも、正確ではありません。2019年の研究が、Nature Human Behaviourに掲載されています。複数文化で集めた2,519件の短い発声を、米国とインドの聞き手に評価してもらいました。
12種類の感情に対応する判断が、両文化で保たれました。一方で、カテゴリ間には連続的な勾配があると報告しています[5]。声には、共有される手がかりもあります。
しかし、文化差を調べたHimba参加者の研究があります。あらかじめ感情語を与えない課題では、西洋で想定された感情分類との一致が再現されませんでした。快・不快の方向では、偶然を上回りました[6]。
つまり、広い情動の方向を捉えられても、細かな感情名を文化を越えた事実として付けられるとは限りません。
この反対方向の証拠を両方残し、使える範囲を狭く定めます。声の特徴は追加確認の入口にはなり得ますが、「本音」「うそ」「購入意向の強さ」の確定にはなりません。
手順4:確認候補に限って運用し、停止条件を決める
確認候補に限るなら、音声分析を監査できます。
CoeSignal(株式会社TechWorkerが提供するAIインタビュープラットフォーム)を使う調査でも、声の推定値を回答者の属性として固定しません。観測事実、モデル出力、人の判断を分け、対象集団と実査環境で誤りを確認します。
これは、音声分析を採用する場合の運用提案です。実装済み機能を説明するものではありません。
音声から得たラベルを使いたいなら、まず少数の本番相当音声で、受入試験を作ります。次のどれかが残るなら、ラベルは調査結論へ入れません。
- 話者群や録音条件で、誤りが偏る。
- 発話内容と矛盾する。
- 別モデルや再評価で、結論が変わる。
感情推定の運用で、うまくいかなくなるのはどんなときですか?
ラベルを本音の証拠にしたとき、公開精度に頼ったとき、偏りを残したまま使ったときに崩れます。
- ラベルで回答を除外し、顧客を順位付けする。感情ラベルは、モデルの推定です。
- 製品説明を精度の証明とみなす。提供会社の説明は、日本語の実査音声や対象顧客での独立した精度証明ではありません。
- 観測・推定・判断を同じ列に入れる。どこで誤ったかを、後から確かめられません。
- 食い違うラベルで逐語録を上書きする。発言内容とラベルは、両方残します。
- 公開ベンチマークの数字を一つ転記する。自社のインタビューでの受入試験にはなりません。
- 偏りを確かめずに使う。平均値が高くても、特定の話者や雑音条件で誤りが集中するなら、その条件では使えません。
- 局所検証なしで、採否、人格評価、虚偽判定へ進む。これは停止条件です。
観測・推定・判断の三つの欄には、何を残しますか?
観測は音の事実、推定はモデル出力、判断は研究者の結論として、別々の欄に残します。
| 欄 | 例 | 誰の出力か |
|---|---|---|
| 観測 | 質問後に4秒の無音。話速が前半より低下 | 音声から得た特徴 |
| 推定 | 苦痛の可能性0.7 | モデル出力 |
| 判断 | 追加確認が必要 | 研究者の判断 |
よくある質問
分かりません。音声から得られるのは、音高や間などの特徴です。不安や怒りは、それを基にしたモデルの推定です。本音や虚偽の判断には二段階の飛躍があるため、ラベルだけで回答を除外してはいけません。
観測した特徴、モデルの推定、人の判断を、別々の欄に残します。ラベルは、人が音声を確認する順番を決める補助に留めます。回答の真偽判定には使いません。発言内容と食い違う場合は、両方を残します。
公開ベンチマークの数字を転記しません。本番と同じ日本語、対象者層、端末、マイク、通信、周囲雑音の音声で、受入試験をします。話者群や録音条件ごとの誤りを分けます。偏りがあれば、その条件では使いません。
次の一歩は何から始めればよいですか?
少数の本番相当音声で受入試験を作り、停止条件を先に決めてから、ラベルの使い道を決めます。
- 観測、推定、判断を、別々の欄に分けます。
- 少数の本番相当音声で、受入試験を作ります。
- 誤りの偏りや内容との矛盾が残る条件では、ラベルを結論へ入れないと決めます。
TechWorkerは、AIインタビューの音声分析について、検証用音声、評価欄、停止条件まで含む受入試験を設計します。
根拠資料
資料確認日:2026年9月30日。本文中の手順例は編集部の提案で、導入効果の実測値ではありません。
- Regulation (EU) 2024/1689
- Expression Measurement API - Hume AI
- Emo-bias: A Large Scale Evaluation of Social Bias on Speech Emotion Recognition
- EmoBox: Multilingual Multi-corpus Speech Emotion Recognition Toolkit and Benchmark
- The primacy of categories in the recognition of 12 emotions in speech prosody across two cultures
- Cultural Relativity in Perceiving Emotion from Vocalizations