
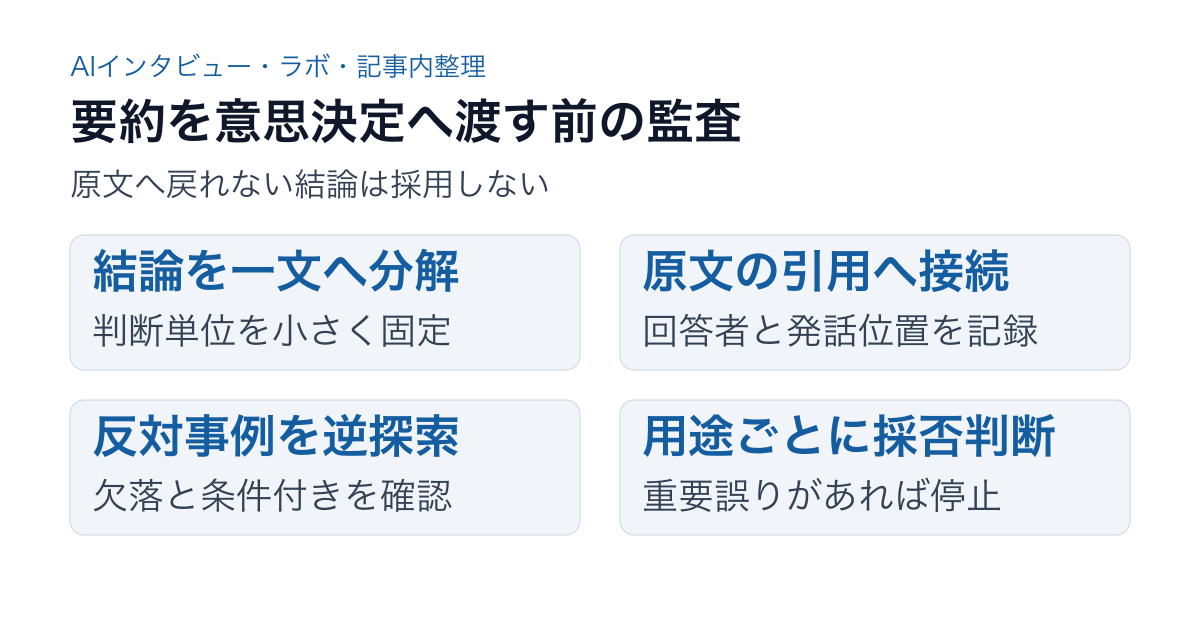
要約文ではなく、原文へ戻れる結論だけを採用する
AIインタビューの要約は、読みやすいだけでは意思決定に使えません。採用できるのは、結論ごとに「誰が、どこで、何を話したか」へ戻れ、反対の発言や保留も確認できる要約です。要約に引用元がない、原文より因果が強い、少数意見が消えている。このどれかが見つかったら、公開や企画判断を止めます。
米国立標準技術研究所(NIST)は生成AIのconfabulation(もっともらしい作話)を、設計上起こり得るリスクとして挙げています。長文や専門的な文脈では、誤った内容を利用者が信じて行動する影響も大きくなります[1]。AIインタビューでは、原文にある語を並べた流暢な要約でも、「不満があった」と「不満が原因で解約した」を混同すれば判断が変わります。
CoeSignal(株式会社TechWorkerが提供するAIインタビュープラットフォーム)で発話を要約・分析する場合も同じです。結論を逐語録の発話位置へ結び、要約だけを正本にしません。
誤りを「追加・取り違え・欠落」の三つに分ける
第一は追加です。回答者が述べていない理由、数字、因果関係が要約へ入っていないかを見ます。第二は取り違えです。質問者の例示を回答者の意見にしたり、別の回答者の条件を混ぜたりしていないかを確認します。第三は欠落です。否定、条件付き賛成、例外、少数意見、判断保留が落ちていないかを調べます。
自然言語処理の国際会議NAACL 2024で発表された研究では、複数の大規模言語モデルが作った要約の平均26.8%に事実不一致が含まれました。研究内で最も良かったChatGPTでも16%でした。主語と目的語の理解も難所でした[2]。この数字は評価用データの結果であり、現在の日本語サービスへそのまま当てはめられません。ただし、要約を無検査で採用できない反例にはなります。
会議要約200件を人が注釈した別研究は、誤りを事実不一致だけに絞らず、構造、欠落、無関係な内容を含む九つへ分けました[3]。AIインタビューでも「書いてあることが正しいか」と「必要なことが残っているか」を別々に採点します。
結論ごとに証拠カードを一枚作る
要約全体へ一つの正確度を付けるより、意思決定に使う結論を小さく分けます。証拠カードには、結論と回答者ID、逐語録の発話位置、原文引用を残します。支持する発言、反対・例外、編集者の判断も同じカードへ記録します。個人名など、報告に不要な識別情報はカードへ複製しません。
要約の事実一致を評価するFactCCの研究は、判定だけでなく、原文の支持範囲と要約内の不一致範囲を抽出しました。人手評価でも、支持範囲の提示が確認作業の助けになりました[4]。製品固有の手法をそのまま導入する必要はありません。実務へ移す要点は、要約文の横に「根拠となる原文」を置くことです。
たとえば「価格が解約の主因」という結論なら、価格に触れた人数だけを数えません。「価格だけで解約した」「機能不足と併記した」「値上げ後も継続した」を分けます。根拠カードが一種類の発言しか持たないなら、結論を狭めるか、反対事例を探し直します。
全件を同じ深さで読まず、危険度で抜き取る
全逐語録を毎回読み直せば、要約の時間短縮は消えます。そこで、まず数値、固有名詞、否定、因果、比較、引用を含む結論を高危険度にします。高危険度は全件、その他は回答者群と質問別に抜き取ります。要約が示さなかった論点を見つけるため、逐語録側から無作為に選ぶ逆向きの抜取も残します。
銀行の顧客・助言者会話を要約したAUTOSUMMは、長い逐語録を分割し、論点の被覆と複数層の誤りを検査しました。300人超の助言者によるフィードバックとモデル版管理も組み合わせています。報告上は事実一致94%、本番要約の89%が編集不要でした[5]。一方、これは開発・導入チーム自身の報告です。日本語の定性調査で同じ数字が出るとは限らず、工程例としてのみ参照します。
少数意見と「分からない」を別枠で探す
要約は繰り返し出た論点を残しやすく、迷い、条件付き回答、一人だけの重大な反例を薄くしがちです。質問ごとに「多数意見」「反対」「条件付き」「判断不能」の四欄を作り、空欄だから存在しないのか、抽出できなかったのかを分けます。人数の少なさだけで反例を削除しません。
2026年の自由回答903件を使った研究では、人とLLMの一致を、偶然の一致を補正するAdjusted Rand Index(ARI)で測りました。符号化は0.61、テーマ生成は0.54でした。人同士、LLMの再実行同士にも不一致があり、変数による差も大きい結果でした[6]。LLMだけが常に悪いという証拠ではありません。人の分析も揺れるからこそ、同じコード定義、反例、原文位置を残し、判断差を見えるようにします。
合格は「原文一致」と「重要論点の被覆」で決める
受入試験は二方向で行います。要約から原文へ戻り、追加・取り違えがないかを見る。逐語録から要約へ進み、重要な反例や条件が落ちていないかを見る。両方を通らない限り、流暢さや短さを理由に合格させません。
共通の合格率は置けません。調査目的、対象者、質問、モデル、指示文で誤り方が変わるためです。最低限、重要な結論はすべて証拠カードへし、反対事例を含む抜取で結論が変わらないかを確かめます。モデルや指示文を変えたときは同じ参照逐語録で再試験します。要約の価値は、読む量を減らすことではなく、確認すべき原文へ早く戻れることに置きます。
根拠資料
資料確認日:2026年9月28日。本文中の手順例は編集部の提案で、導入効果の実測値ではありません。
- Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile
- Exploring the Factual Consistency in Dialogue Comprehension of Large Language Models
- What’s Wrong? Refining Meeting Summaries with LLM Feedback
- Evaluating the Factual Consistency of Abstractive Text Summarization
- AUTOSUMM: A Comprehensive Framework for LLM-Based Conversation Summarization
- LLMs for Survey Text Analysis - A Performance Comparison Between Humans and GPT-5 on Inductive Content Analysis