
文字が読めても、分析に使える逐語録とは限らない
AIインタビューの文字起こし精度は、「だいたい読める」で判定できません。商品名を別の商品へ、否定を肯定へ、三千円を三万円へ変換すれば、誤りは一語でも判断を変えます。話者の割り当てが逆なら、回答者の発言を質問者の発言として分析しかねません。見るべきものは平均精度だけでなく、誤りが分析結論へ届く経路です。
NISTは音声認識の誤りを、別の語に置き換わる「置換」、語が消える「削除」、話していない語が入る「挿入」に分けています[1]。この三分類から計算する単語誤り率は比較に役立ちます。ただし、助詞一語と商品名一語を同じ一件として数えるため、調査上の重要度までは表しません。
CoeSignal(株式会社TechWorkerが提供するAIインタビュープラットフォーム)のように音声回答を分析へつなぐ場合も、録音、文字、話者、引用の各段階を分けて確認する必要があります。
対象者ごとの誤差を平均値に埋めない
音声認識の誤りは話し方によって偏ります。米国5都市のインタビュー音声19.8時間を5社のシステムで比べた研究では、黒人話者の平均単語誤り率は0.35、白人話者は0.19でした[2]。2020年時点の英語研究なので、この数字を現在の日本語サービスの精度には使えません。それでも、全件平均が特定の話者群の失敗を隠すという問題は残ります。
吃音を含む発話を6つの音声認識で検証した2024年の研究でも、非流暢な発話に対する統語・意味上の誤りが一貫して確認されました[3]。日本語の方言、第二言語話者、高齢者、早口、小声についても、標準的な読み上げ音声の結果で代用せず、対象者に近い音声を試験用に残します。属性を評価するためではなく、誰の声が記録から落ちやすいかを発見するためです。
誤りを文字・話者・分析の三層で検査する
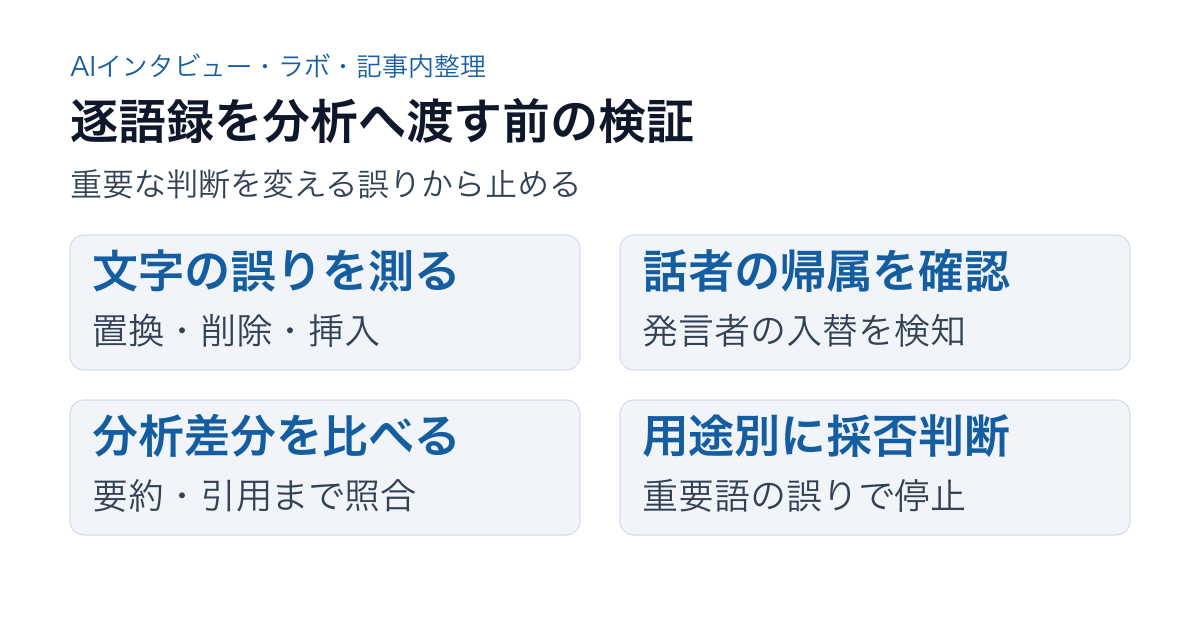
第一層は文字です。人が確認した短い参照逐語録を作り、置換・削除・挿入を数えます。全体値とは別に、商品名、競合名、価格、数量、否定表現、選択理由を「重要語」として採点します。第二層は話者です。質問者と回答者の発言が正しく分かれ、発話の重なりや短い相づちで入れ替わっていないかを見ます。
第三層は分析です。同じ音声について、人手逐語録と自動逐語録から別々に要約やコードを作り、主要テーマ、引用、判断が変わるかを比べます。心理療法の面接を調べたACLの研究は、一般的な誤り率に加えて領域上の重要語を評価し、音声認識の誤りが後段の発話コーディングへ及ぼす影響を検証しました[4]。市場調査でも、「読めるか」より「結論が変わるか」まで追う必要があります。
本番条件の音声で受入試験を作る
試験音声には、静かな部屋だけでなく、実際に想定する端末、通信、周囲音、話速を含めます。Google Cloudは、マイクを話者へ近づけること、音割れを避けること、言語やモデルを正しく指定することを推奨しています。複数話者を別チャンネルで録音できる場合は分け、声の重なりや音量差があると一部を背景音として無視し得るとも説明しています[5]。
話者分離も初期設定のままにしません。Microsoftは、短い発話、背景音、想定話者数を含む試験音声を用意し、言語候補と話者分離を明示的に設定するよう案内しています[6]。本番が一対一なら、一対一の音声で話者交代の正しさを確かめます。会議録の公開ベンチマークが高精度でも、スマートフォン越しの一対一インタビューにそのまま移せません。
固有語は辞書へ入れ、修正履歴を分析と分ける
商品名、部署名、業界略語は、録音前に一覧へします。Amazon Transcribeは、一般語彙で誤認識されやすいブランド名、略語、固有名詞へカスタム語彙を使えると説明しています[7]。辞書登録後は、登録語と似た音の一般語を両方再試験します。登録語の改善だけでなく、一般語を商品名へ誤変換していないかも確認するためです。未公開の商品名や顧客名、個人名など、機密情報・個人情報はカスタム語彙へ登録しません。利用する音声認識サービスの保存先、権限、利用条件も事前に確認します。
自動修正した箇所には、元の認識結果、修正後、修正者、音声位置、理由を残します。引用に使う発言は音声へ戻れる状態にし、分析者が文意を整える編集と、聞き間違いの訂正を同じ欄に入れません。国立国語研究所の日本語自然会話コーパスは、語だけでなくフィラー、沈黙、笑い、発話の重なりも文字化しています[8]。すべてを詳細に記す必要はありませんが、調査目的に必要な非語彙情報を先に決めないと、文字起こし時点で証拠を捨てることになります。
合格基準は「重要な判断が変わらない」に置く
受入基準には、全体の単語誤り率、重要語の誤り、話者帰属、要約・コードの一致を並べます。重要語や話者の誤りで結論が変わるなら、平均値が良くても自動逐語録だけでは分析しません。該当箇所を人が確認するか、対象条件では音声を一次証拠として扱います。
限界もあります。ここで挙げた独立研究の多くは英語や臨床会話を対象にし、製品資料は各社が示す推奨設定です。日本語のAIインタビューへ共通の合格率を与える根拠にはなりません。対象者に近い参照音声を作り、結論を変える誤りから直す。それが、文字起こしの速さを調査品質へ結びつける最短の検証です。
根拠資料
資料確認日:2026年9月27日。本文中の手順例は編集部の提案で、導入効果の実測値ではありません。
- Performance assessment of automatic speech recognizers
- Racial disparities in automated speech recognition
- Lost in Transcription: Identifying and Quantifying the Accuracy Biases of Automatic Speech Recognition Systems Against Disfluent Speech
- Evaluating Automatic Speech Recognition Quality and Its Impact on Counselor Utterance Coding
- Best practices | Cloud Speech-to-Text
- Configure language identification and diarization for speech transcription
- Custom vocabularies - Amazon Transcribe
- 特集:世界最大規模のBTSJ日本語自然会話コーパス