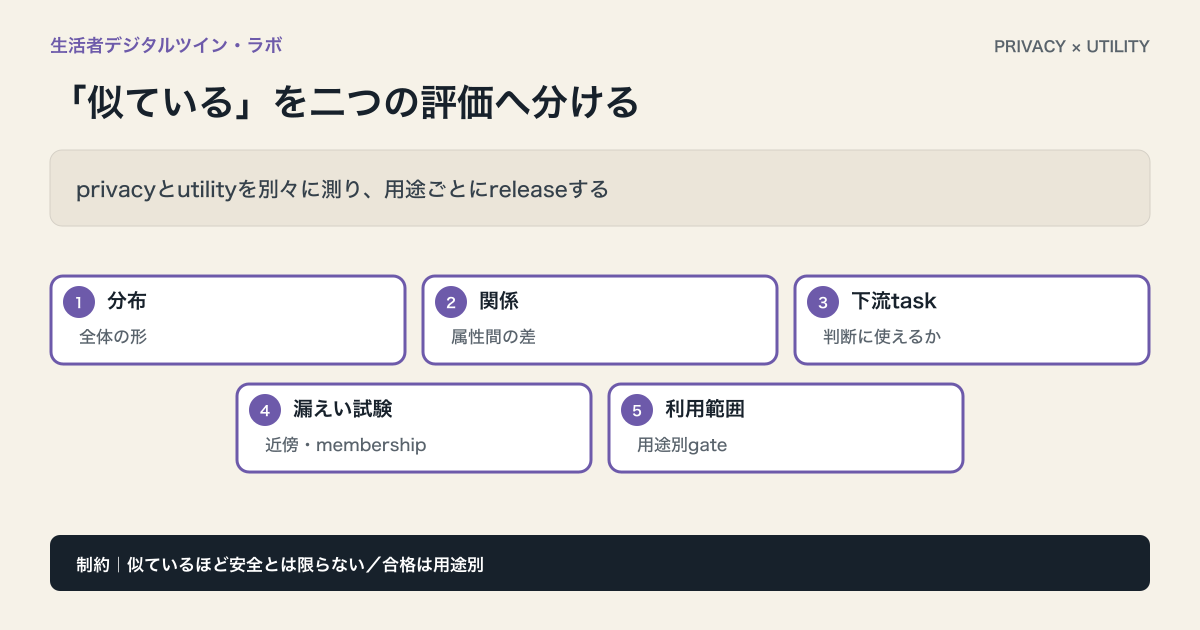
生活者デジタルツインが実在顧客に似ているほど「精度が高い」とは限りません。少数の顧客記録や珍しい属性をそのまま再現すれば、元データの推測や再識別につながる可能性があります。一方、保護を強めすぎると、価格や訴求の比較に必要な差まで消えます。必要なのは、privacyとutilityを別の試験として測り、利用目的ごとに許容範囲を決めることです。
先に「何へ使える」を定義する
「実顧客に近い」という目標は曖昧です。広告コピーの反応仮説、設問の事前確認、価格候補の論点抽出、サポート導線の弱点探索など、下流タスクを一つに絞ります。そのタスクで保持すべき統計関係と、保持してはいけない個人特有の情報を分けます。
NISTのsynthetic data challengeは、生成データのutilityとprivacyを両方評価する手順を示しています[1]。utilityは元データとの見た目の一致だけでなく、synthetic dataから得た推論がground truthに対してどの程度信頼できるかを見る考え方です。生活者デジタルツインも、自然な文章かではなく、意思決定に使う比較が再現されるかを試します。
utilityを三段階で確認する
utilityは次の三段階に分けます。
- 分布:属性や回答の分布が大きく崩れていないか。
- 関係:重要な属性間の相関や条件差が保持されるか。
- 下流タスク:実際の仮説選定・分類・比較が同じ方向を示すか。
全体平均が合っていても、少数segmentや交互作用が消えていれば、その用途には使えません。反対に、全変数を高精度に再現しなくても、設問の理解障壁を洗い出す用途には十分な場合があります。合格基準を用途ごとに置き、ひとつの総合scoreで全用途を許可しません。
privacy leakageを攻撃者の視点で試す
ICOは、synthetic dataが実データの性質を強く再現するほどutilityが上がる一方、個人情報を明らかにする可能性も増えると説明しています[2]。珍しい属性の組み合わせ、極端値、少数層、原文に近い自由回答を重点確認します。
検査には、nearest-neighborの近さ、元データとの一致、membership inference、属性推測、自由回答の重複などを使います。攻撃者が持ち得る補助情報を想定し、公開範囲や利用者権限ごとに試します。「名前を消した」だけでanonymousとみなしません。生成モデルの学習・評価に使った実データの処理自体には、引き続き保護義務が生じます[3]。
segment平均だけで安全を判断しない
全体でprivacy riskが低くても、少数segmentだけ元記録へ近い場合があります。年齢×地域×購買履歴のような組み合わせで、件数、距離、重複、utilityを確認します。ただし小さなcellをそのまま報告して新たな漏えいを作らないよう、閲覧権限とminimum cell ruleを設定します。
基礎データに偏りがあれば、synthetic dataもその偏りを維持・増幅する可能性があります。OECDは、synthetic dataでもdata fidelityとprivacyの両方を検証し、意思決定の記録とgovernanceを残す必要性を述べています[4]。ツインの回答が一貫していても、市場全体を代表する証明にはなりません。
release gateを利用範囲ごとに置く
内部の仮説探索、限られた担当者の分析、顧客向け提示、外部共有ではriskが違います。各利用範囲に、使用可能な変数、出力形式、保存期間、再生成条件、人の確認、禁止判断を設定します。privacy試験が不合格ならモデルや入力を変え、utilityが不合格なら用途を狭めます。両方を満たさないまま「平均して良い」と公開しません。
公開後は実査との差、分布変化、データ更新、攻撃手法を定期再評価します。関連する元データのprivacy設計、精度とbias検証、segment仮説検証も参照してください。
生活者デジタルツインのデータ・検証設計を相談する
評価結果を一枚で残す
評価表には、元データの期間・対象、生成方法と版、想定利用者、利用目的、utility試験、privacy試験、少数segmentの結果、禁止用途、再確認期限を記録します。privacyとutilityで使うデータ分割を管理し、同じ検証データへ過度に合わせ込まないようにします。
実査結果が得られた後は、合っていた回答だけを選んで精度を報告しません。方向が外れたsegment、回答が均質化した設問、自由回答で失われた少数意見を記録し、次版の入力・生成・利用範囲のどこを直すか決めます。改善しても過去版の評価を上書きせず、比較可能な履歴を残します。
適用限界
privacy metricが低リスクでも匿名性を絶対保証しません。utilityが高くても将来の市場反応や個人の行動を保証しません。高影響判断は実在利用者の調査、法務・privacy専門家、セキュリティ評価を組み合わせます。
一次情報と確認範囲
確認日:2026年9月18日。製品仕様・制度は更新されるため、導入時はリンク先の最新版を再確認してください。海外の制度・職業規範は日本へ直接適用せず、相違点と限界を本文に明記しています。