
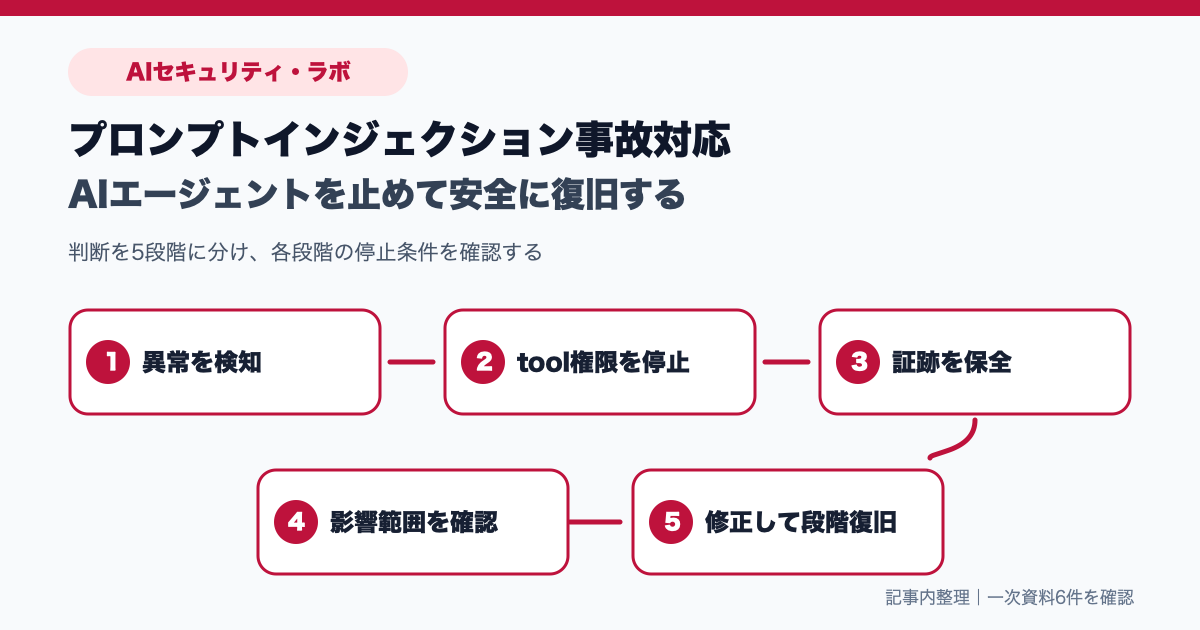
プロンプトインジェクションの事故では、最初に何をしますか?
出力より先に、該当エージェントが使う外部機能の認証情報を無効化し、書き込み権限、外部通信、長期記憶への保存を止めます。
プロンプトインジェクションは、不正な文章がモデルの回答を変えるだけでは終わりません。AIエージェントのtool実行、外部送信、記憶保存へ進むと、業務事故になります。
OWASP LLM01:2025は、直接・間接のprompt injectionが次につながると整理しています[1]。
- 不正な意思決定
- 情報露出
- 無許可の機能実行
検知後にpromptを修正するだけでは不十分です。権限を止め、入力・判断・tool call・外部影響を一続きで保全し、安全な版へ段階復旧する必要があります。
異常を見つけたら、会話画面だけを閉じません。該当agentの外部機能の認証情報、書き込み権限、外部通信、長期記憶への書込みを停止します。
事故対応は、どんな順序で進めればよいですか?
権限の停止、証跡の保全、影響範囲の確認、段階復旧、平時の演習の5つの順で進めます。
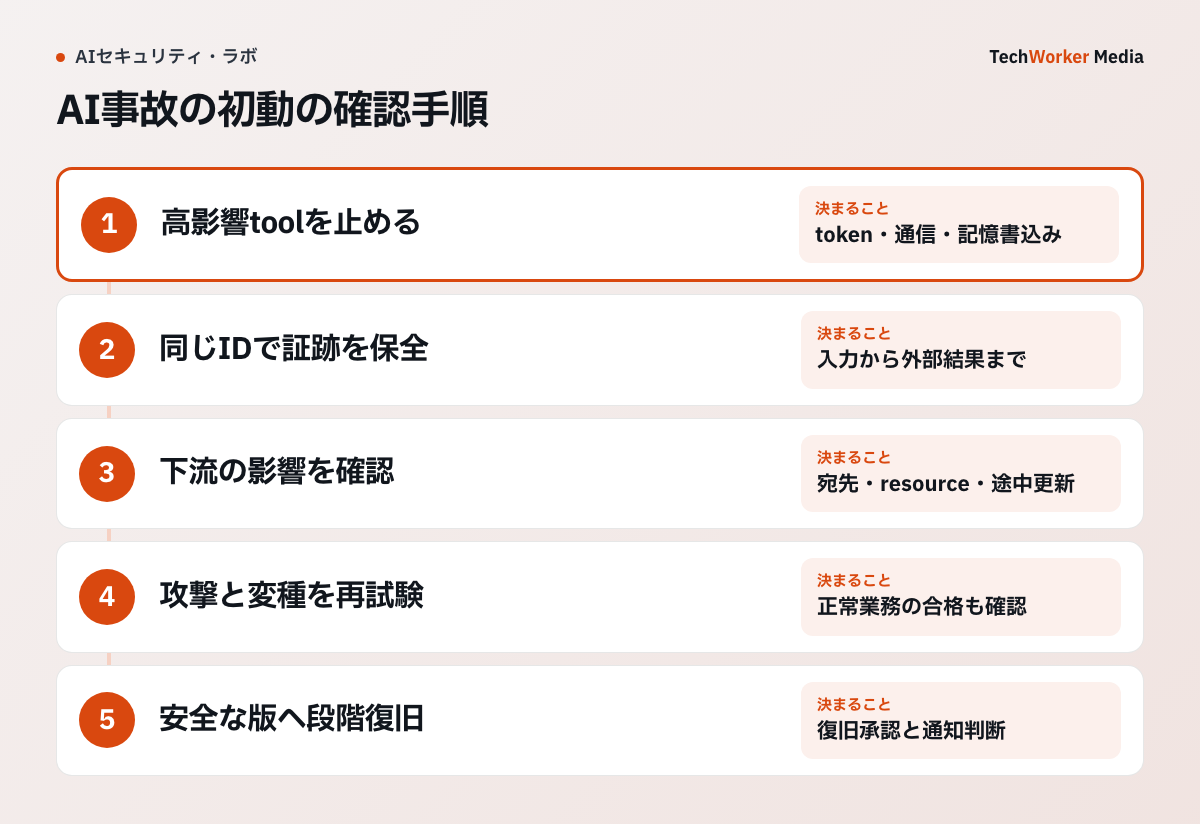
初動の設計例では、当直が該当connectorの書込みと送信を止め、調査担当が同じincident IDで入力から外部APIの結果まで保全します。業務責任者が影響する案件を確認し、復旧する操作と通知判断を決めます。机上演習では停止の判断、連絡先、権限の所在を確認します。別途、検証環境で権限停止を実行し、操作が拒否された記録を確かめます。
- 権限を止めます。read-only調査と外部副作用を分けます。送信・削除・権限変更など、高影響のtoolを優先して遮断します。全AI機能を無条件に止めず、影響が疑われるtenant、agent、connector、時間帯を特定します。被害の拡大を防ぐためです。
- 証跡を上書きせず保全します。次の情報を、incident IDで結びます。入力本文、取得文書、system/developer instructionの版、modelです。tool call、引数、承認、response、外部API結果、記憶更新も結びます。ログに機密promptが含まれる場合は、閲覧権限と保持期間を限定します。調査のために、別系統へ無制限に複製しません。NIST AI 600-1は、生成AIのincidentを既存のrisk managementへ統合します。eventの記録、責任、post-deployment monitoringを扱います[2]。MITRE ATLASのincident sharingも、サニタイズした技術情報の共有を示します。実例に基づく防御へつなげる考え方です[3]。
- 影響範囲をtool単位で確認します。危険な回答が出たかだけを見ません。どのtoolが実行されたか、対象resource、権限、結果、下流処理を確認します。成功responseでも、宛先や対象が誤っていればincidentです。失敗responseでも、partial writeがないとは限りません。Google CloudのAI/ML security guidanceは、AI固有の対応を示しています。preparation、eradication、recovery、post-incident activityです。prompt injectionなどに合わせたplaybookを求めています[4]。中央SOC、法務、業務責任者へのescalation条件は、事前に決めます。
- 安全な版へ戻し、再検証します。原因に応じて対処を変えます。修正後は、実際の攻撃入力と変種をreplay(再実行)します。toolが呼ばれないこと、警告が出ること、正常業務が壊れていないことを確認します。GoogleのSAIFは、AI向けincident typeに合わせた調整を勧めています。調整するのは、abuse policyとresponse processです[5]。
- 平時にplaybookを演習します。次をplaybookへ固定します。検知条件、即時停止権限、証跡場所、連絡先です。影響確認query、復旧承認、顧客通知判断も固定します。四半期ごとの机上演習では、間接的なプロンプトインジェクションを想定し、当直者の判断と連絡の手順を確認します。技術訓練では検証環境の権限を実際に停止し、拒否された操作とログを確かめます。
うまくいかない例には、どんなものがありますか?
promptの修正だけで終えること、画面だけ閉じること、一度のfilter成功で復旧とすることが典型です。
- promptを直すだけで終えます。tool実行や外部送信が残っていれば、事故は続きます。
- 会話画面だけを閉じます。外部機能の認証情報、書き込み権限、外部通信、記憶書込みは動いたままです。
- 全AI機能を無条件に止めます。影響のないtenantやagentまで止まります。
- 危険な回答の有無だけを見ます。tool実行と下流処理を確認しないと、影響範囲が分かりません。
- 成功responseを正常と見なします。宛先や対象が誤っていれば、incidentです。
- 調査のためにログを複製します。機密promptが別系統へ広がります。
- 一度のfilter成功で復旧とします。攻撃入力と変種を再実行して、確かめます。
入力filterやモデルguardrailだけでは、prompt injectionを完全に防げません。検知できないことを前提にします。最小権限、承認、sandbox、出力後validation、監査を重ねます。海外frameworkは、自社の法的通知義務を代替しません。日本の契約・個人情報・業界規制を、別途確認します。
原因ごとに、復旧はどう変わりますか?
取得文書、prompt template、tool policy、長期記憶で、隔離や修正の対象が変わります。
| 原因 | 復旧の対処 |
|---|---|
| 取得文書 | 隔離し、再取得する |
| prompt template | 版を戻す |
| tool policy | allowlistと引数validationを修正する |
| 長期記憶 | 対象memoryを隔離し、別tenantへ伝播していないか確認する |
よくある質問
会話画面を閉じるだけでなく、該当agentの権限を止めます。外部機能の認証情報、書き込み権限、外部通信、長期記憶への書込みです。送信・削除・権限変更など高影響のtoolを優先して遮断します。影響が疑われるtenant、agent、connectorを特定して、被害拡大を防ぎます。
入力本文、取得文書、instructionの版、modelを残します。tool callと引数、承認、response、外部API結果、記憶更新も残します。すべてincident IDで結びます。機密promptを含むログは閲覧権限と保持期間を限定し、別系統へ無制限に複製しません。
すぐには復旧しません。実際の攻撃入力と変種を再実行し、toolが呼ばれないこと、警告が出ること、正常業務が壊れていないことを確認します。一度のfilter成功だけで復旧とせず、安全な版へ段階的に戻します。
次の一歩は何から始めればよいですか?
停止権限と証跡の場所を決めます。机上演習で判断と連絡を確認し、検証環境の技術訓練で権限停止が機能するか確かめます。
- 検知条件、即時停止権限、証跡場所、連絡先をplaybookへ固定します。
- 影響確認queryと、復旧承認、顧客通知の判断を決めます。
- 四半期ごとに、間接的なプロンプトインジェクションを想定した机上演習を行います。別途、検証環境で権限停止を試験します。
出典と確認範囲
確認日:2026年9月19日。製品仕様・制度・研究結果は更新されるため、導入時はリンク先の最新版を再確認してください。