
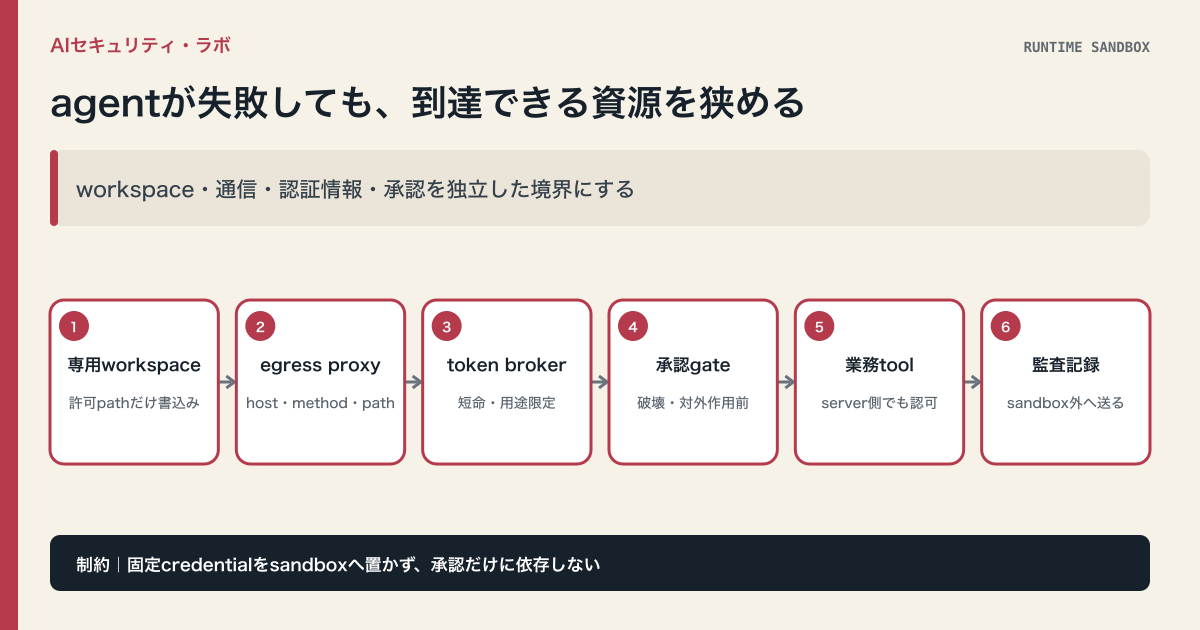
AIエージェントの被害範囲は、どうすれば閉じられますか?
指示に頼らず実行環境を技術的に制限します。目的は、失敗しても到達できる資源を限ることです。
AIエージェントへ「危険な操作をしないで」と指示するだけでは、被害範囲は閉じません。誤った推論、prompt injection(入力に紛れた命令による乗っ取り)、悪意のある入力が起きる前提で設計します。
次の4点を、技術的に狭めます。書ける場所、通信先、使える認証情報、承認なしに実行できる操作です。
サンドボックスの目的は、モデルを善良にすることとは異なります。失敗しても到達できる資源を限定し、外へ出る例外を記録できるようにすることです。
サンドボックスは、どんな手順で設計しますか?
4能力の既定を狭く決め、workspace、通信先、認証情報、監査ログの順に絞ります。
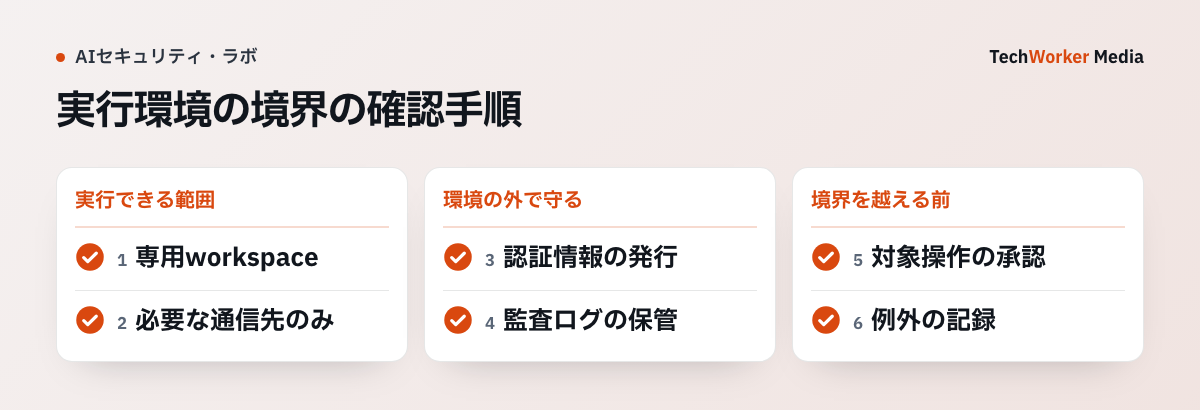
営業資料の下書きを作る設計例なら、読む資料と保存先を専用workspaceへ絞ります。必要な検索先だけを通信proxyへ登録し、顧客メールの送信は環境へ登録しません。認証情報と監査ログは、agentが書き換えられる場所の外へ置きます。
- 4能力の既定を決めます。ファイルへのアクセス、外部通信、認証情報、操作の承認について、初期状態で許す範囲を狭めます。例外は個別に記録します。OpenAIはCodexの安全な実行を説明しています[1]。sandboxとapprovalを組み合わせ、network accessを制限する構成です。通常操作は狭いsandbox内で自動化し、境界を越えるときだけ確認します。
- workspaceを専用にします。通常は専用workspaceだけをread/write可能にします。ホームディレクトリ、SSH key、cloud CLI設定、他project、秘密ファイルはmountしません。Anthropicはagent containmentで、複数の層を組み合わせる考え方を示しています[2]。層は、filesystem、VM、egress controlです。OWASPもcoding agentに、分離を推奨しています[3]。例は、devcontainer、restricted shell、VM、ephemeral workspaceです。
- egressを絞ります。egressは、環境から外へ出る通信です。許可domainでも、漏えい経路になる場合があります。upload endpoint、issue作成、webhook、server-side fetchがある場合です。policyにはhostに加え、次の項目を含めます。HTTP method、path、body size、content type、転送可能な識別子、taskとの関係です。可能ならagentは直接internetへ出ません。policy enforcement proxyを通し、許可理由とresponseを記録します。
- credentialをworkspaceへ置きません。固定API keyやSSH keyを環境変数やfileで渡すと、agentが読める時点で外部送信や誤利用が可能です。認証情報はhost側またはbroker側に置きます。task、resource、操作、期限を限定したtokenへ交換します。Anthropicは、credentialをhost keychain側へ置く構成を説明しています[2]。
- 監査ログを環境の外へ出します。agentが削除できるworkspace内だけにログを置かず、環境の外へ送ります。task ID、inputの分類、tool、target、承認、結果、token発行、egressを残します。prompt全文や秘密を無制限に記録しないよう、本文とmetadataを分けます。
低リスクのread-only検索まで、常に完全VMを必須にするのは過剰です。扱う資源と外部作用に応じて、process隔離、container、microVMを選びます。
サンドボックス設計がうまくいかない例には、どんなものがありますか?
承認に頼り切る、allowlistを安全と見なす、管理を外部へ任せきる、他の防御を省く、の4つです。
- 承認を人の注意力へ寄せ切る。承認は重要ですが、すべてを人に確認させると形骸化します。
- allowlistを「安全なdomain一覧」と見なす。Anthropicは、承認済みdomainを経由したexfiltration(外部への持ち出し)を見落とした事例を公開しています。宛先名だけでは不十分だと説明しています[2]。
- 同じhost上の隔離を確認せず信用する。kernelやmount設定など、実装条件を確認します。NIST SP 800-190は、4つを別のリスク面として扱います[4]。container image、runtime、host、orchestratorです。
- managed runtimeに権限設計まで任せる。AWS AgentCoreはsession isolationを提供します。一方で、利用者側の責任が残ると明記しています[5]。対象は、agent code、IAM、input validation、network設定です。Code Interpreterではnetwork modeを選べます。Sandbox、VPC、Publicを用途で分けます[6]。
- sandboxだけで安心する。サンドボックスは、虚偽出力、誤認可、業務規程違反を単独で防ぎません。server側認可、input検査、tool schema、red team、監査と組み合わせます。
それでもsandboxが必要なのは、他の防御が一つ失敗したときの被害範囲を閉じるためです。
4能力は、既定と例外の与え方でどう違いますか?
既定は、専用workspace、denyか最小allowlist、常設なし、事前承認です。例外は明示して与えます。
| 能力 | 既定 | 例外の与え方 |
|---|---|---|
| filesystem | 専用workspaceのみ書込み可 | task単位の明示path |
| network | denyまたは最小allowlist | method・host・path・用途を限定 |
| credentials | agentへ常設しない | proxy経由の短命token |
| approval | 破壊・対外作用前に要求 | 対象と差分を表示 |
よくある質問
足りません。誤った推論、prompt injection、悪意のある入力が起きても被害を閉じるには、技術的に狭める必要があります。対象は、書ける場所、通信先、使える認証情報、承認なしに実行できる操作です。指示はモデルの判断に依存するためです。
安全とは限りません。許可domainでも、漏えい経路になる場合があります。upload endpoint、issue作成、webhook、server-side fetchがある場合です。hostだけでなくHTTP method、path、body size、taskとの関係も含めます。可能ならpolicy proxyを通して記録します。
不要にはなりません。session isolationのような機能は提供されても、利用者側の責任が残ります。対象は、agent code、IAM、入力検証、network設定です。Code Interpreterでもnetwork modeを用途で分けて選びます。
次の一歩は何から始めればよいですか?
いまのエージェントが書ける場所、通信先、持っている認証情報を、棚卸しすることから始めます。
- エージェントが書ける場所と、mountしているファイルを洗い出します。
- 通信先をdenyにし、必要な宛先だけをmethodとpathつきで許可します。
- 認証情報をworkspaceから外し、短命tokenとログの外部送信に切り替えます。
出典(一次情報と確認範囲)
確認日:2026年9月16日。製品仕様・制度は更新されるため、導入時はリンク先の最新版を再確認してください。本文は技術的な設計例です。国内法や契約上の義務は、導入先の条件に応じて確認してください。