
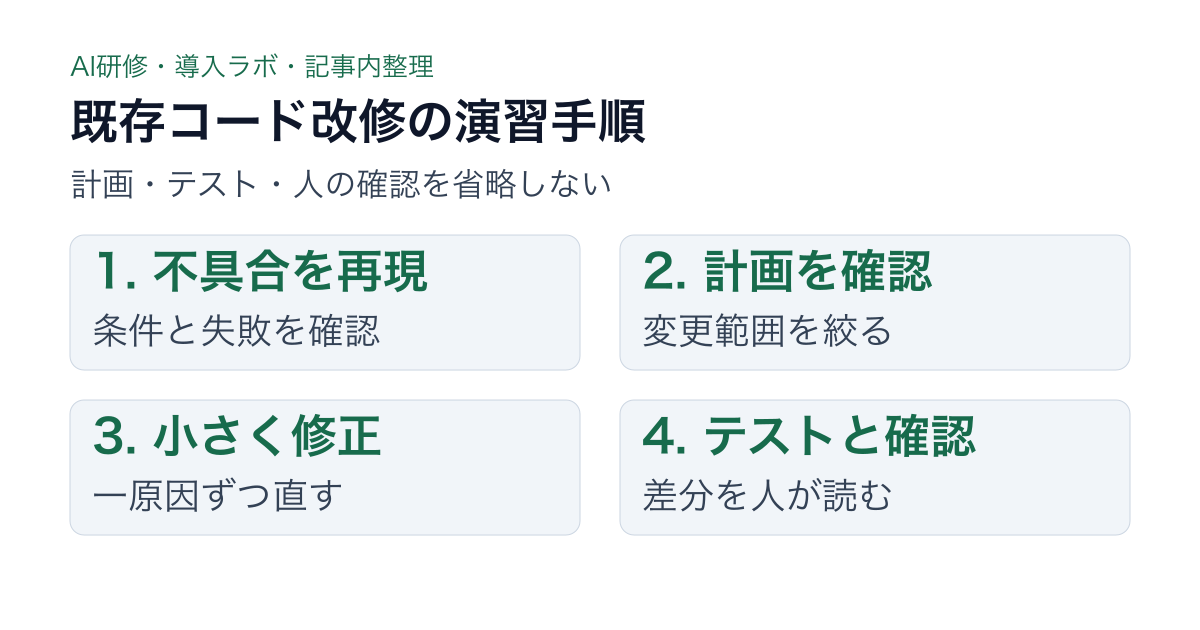
Claude Code研修は「1件の修正を完了する型」まで教える
Claude Codeの法人研修では、便利なコマンドやプロンプトを並べるだけでは足りません。受講者が持ち帰るべきものは、既存コードを調べ、変更案を確認し、小さく直し、テストと人のレビューを通す一連の型です。題材は小さくて構いません。たとえば「入力が空のときだけエラーになる」という不具合です。意図しない変更を見つけて止める練習に時間を使います。
Anthropicの公式資料も、既存コードの探索、不具合修正、リファクタリング、テストを別々の小技ではなく、日常の開発手順として案内しています。Plan Modeでは、Claude Codeがファイルを読み、読み取り専用のコマンドで調査し、計画を示しますが、ソースファイルは編集しません[1]。研修ではこの性質を使い、編集前に人が変更範囲と検証方法を確認します。
導入率が高くても、出力への信頼は追いついていない
2025年のStack Overflow Developer Surveyには49,000人を超える開発者が回答しました。84%がAIツールを利用している、または利用予定である一方、出力精度を信頼しない人は46%、信頼する人は33%でした。「ほぼ正しいが、完全には正しくない回答」に困るという回答も66%に達しています[2]。研修の課題は、AIを使わせることより、もっともらしい誤りを見抜く手順を定着させることです。
DORAの2025年調査は、約5,000人への調査と100時間を超える定性調査から、AIは組織の強みと弱みを増幅すると結論づけました[3]。この結論を研修設計へ当てはめると、テストが遅い、完了条件が曖昧、レビューが属人的といった状態のままでは、生成速度だけが上がっても手戻りが増えかねません。研修の前に、再現コマンド、変更禁止範囲、受入条件を決めておく理由はここにあります。
90分演習は調査、計画、修正の順で進める
最初の15分で、受講者は研修用リポジトリの状態、対象機能、テストコマンドを確認します。実案件や機密コードは使わず、本番に似せた小さな教材を用意します。修正はまだ頼みません。「不具合を再現し、関係するファイル、原因の仮説、触らない範囲、検証方法を示す」と依頼します。ここで再現できなければ、編集へ進みません。
次の20分はPlan Modeで変更計画を作ります。計画には、変えるファイル、変えないファイル、先に追加する再現テスト、想定する副作用を含めます。受講者は計画をそのまま承認せず、要求と違う箇所、広すぎる変更、根拠のない互換処理を指摘します。続く40分を修正とテストに割り当て、1回の変更を1原因に絞ります。複数の修正案をまとめて適用すると、どの変更が効いたのか追えなくなるからです。
指示文書と権限設定を混同しない
CLAUDE.md、または対応版と読込設定を確認したAGENTS.mdには、テストコマンド、ディレクトリ構成、命名規則、毎回守る作業手順など、繰り返し説明する事実を書きます。Anthropicの資料は、これらをClaude Codeへ文脈を与える仕組みと位置づけています。AGENTS.mdの直接読込はClaude Code v2.1.277以降が対象で、既定では作業ディレクトリ以上にCLAUDE.mdやCLAUDE.local.mdがない場合に限られます。両方を使う場合は設定またはimportを確認し、/memoryで実際に読まれたファイルを確かめます。一方で、どちらも強制設定ではありません。禁止操作を確実に止めるには、権限規則や事前フックを使う必要があります[4]。
現在の公式資料では、権限モードによってファイル編集やコマンド実行の扱いを変えられます。Plan Modeは調査用ですが、通常の編集段階では別の権限が働きます[5]。研修では「指示に書いたから安全」と説明せず、教材環境、作業ディレクトリ、許可する操作を分けて確認します。権限を省略するモードを通常の社内研修で勧めるべきではありません。
テストは生成させるだけでなく、失敗の意味を読む
修正前には、対象の不具合を再現するテストを1件追加します。まず失敗を確認します。そのテストが修正後に通ることを確かめます。続けて既存テスト、型検査、静的検査を実行します。Claude Codeの公式資料も、既存のテスト様式を読み、境界値や異常系を追加し、実行結果を確認する流れを示しています[1]。
ただし、テストの通過は採用を意味しません。期待値を書き換えて失敗を隠していないか、テストを無効化していないか、関係のないファイルまで直していないかを差分で読みます。最後の15分は、人が要求との一致、副作用、読みやすさ、テストの妥当性を確認し、採用、差戻し、破棄のいずれかを選びます。Anthropic社内の利用例にも、疑似コード、テスト駆動、途中の介入を組み合わせる例がありますが、製品提供者の自社事例であり、独立した効果測定ではありません[6]。
成果は体感時短ではなく、差戻しと再発で測る
研修の効果は、完了時間に加え、意図外変更、レビュー差戻し、既存テストの失敗、同じ不具合の再発を、AIを使わない基準値と比べます。METRが2025年前半に実施した無作為化比較試験では、熟練したオープンソース開発者16人が246件の実課題に取り組み、AI利用時は完了まで19%長くかかりました。参加者は実際には遅くなった後も、20%速くなったと感じていました[7]。
範囲は狭い研究です。大規模な既存プロジェクトに習熟した少人数の開発者と、2025年前半のツールを対象にしており、現在の全開発者へ一般化はできません。METRの2026年更新では、高速化を示す生データも出ましたが、AIなしの作業を避ける参加者や課題の選択偏りが大きく、現在の生産性効果を信頼できる形では推定できないと説明しています[8]。それでも、自己申告の時短だけでは研修効果を判断できません。Claude Code研修は、1件の修正を安全に終えられるかを観察し、失敗した工程を次の演習へ戻すところまで設計して初めて、現場で使える研修になります。
根拠資料
資料確認日:2026年9月26日。本文中の手順例は編集部の提案で、導入効果の実測値ではありません。
- Common workflows - Claude Code Docs
- 2025 Stack Overflow Developer Survey
- State of AI-assisted Software Development 2025
- How Claude remembers your project
- Configure permissions - Claude Code Docs
- How Anthropic teams use Claude Code
- Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity
- We are Changing our Developer Productivity Experiment Design