研究原文:Guest・Bunce・Johnson「How Many Interviews Are Enough?」(Field Methods、2006年、2026年10月6日確認)
114テーマの70%が最初の6件、92%が12件以内に現れた研究です。読むべき点は数字だけでなく、対象が同質で、目的が狭く、共通の質問ガイドを使ったことです。「12人」を別の調査へそのまま移さず、どの集団で、何の意味が新たに出なくなったかを記録します。
出典:2006年のField Methods原著/2020年の著者らによる要約。研究条件を外して人数だけを一般化しません。
「12人で飽和」が得られた条件
Guestら(2006)が、西アフリカ2か国の女性セックスワーカー60名へ、同じ質問ガイドで行った分析から得た数字です。
著者らは60件の深層インタビューを順にコード化し、新しいテーマが何件目まで現れるかを調べました。ここでいう飽和は、同じ問いを続けても新しいテーマがほとんど増えなくなる状態です。
2006年研究について、Guestらの2020年論文は、114テーマの70%が6件、92%が12件までに現れたと先行研究レビューで要約しています。2020年に同じデータを再分析して得た新しい結果ではないため、2006年原著の結果と後続の要約を分けて記します。
この研究が示したのは、一定の条件なら初期の十数件でテーマの大半を捉えられることです。異なる職種や拠点を比べる調査、回答者ごとに質問が大きく変わる調査、意味の細部まで解釈する調査の必要人数は、この実験だけでは決まりません。
2022年の系統的レビューが示した範囲
23論文のレビューでは、インタビュー9〜17件で飽和という報告が並んでいますが、条件付きです。
2006年以降、飽和を実データで検証する研究が積み上がりました。その到達点を集計したのが、Hennink & Kaiser(2022)です(“Sample sizes for saturation in qualitative research: A systematic review of empirical tests”、Social Science & Medicine 292)。
飽和を実証的に検証した23本の論文を、体系的にレビューしています。実データに基づく研究では、インタビュー9〜17件、フォーカスグループ4〜8回で飽和に達していました。
Guestらの12件は、この9〜17件のレンジのほぼ中央に収まります。2006年の結果は、後続研究でも、同質な集団と狭い目的で近い範囲が報告されています。
ただし、レビュー著者自身が明記しているとおり、対象となった研究は同質な集団・狭い目的の調査に偏っています。9〜17件は、そうした条件の調査で観察された範囲です。あらゆる定性調査への推奨値ではありません。
コード飽和と意味飽和は別物
答えを1つの数字に丸められない理由が、もうひとつあります。何をもって飽和とするかで、必要な件数が変わることです。
Hennink, Kaiser & Marconi(2017)は、25件のHIV患者インタビューで、飽和を2種類に分けて測りました(“Code Saturation Versus Meaning Saturation”、Qualitative Health Research 27(4))。
- コード飽和は、新しいトピックが出なくなる点です。「もう聞くことがない」状態で、9件で到達し、新規コードの91%を特定しました。
- 意味飽和は、各トピックの意味・ニュアンスを理解し切る点です。「もう学ぶことがない」状態で、16〜24件が必要でした。
9件で話題の一覧は出そろいますが、意味を理解し切るには16〜24件かかりました。必要な人数は、ほぼ2倍違います。
Guest, Namey & Chen(2020)も、基準の置き方で答えが変わることを示しました(PLOS ONE 15(5))。
新規情報の閾値を5%以下とするなら、6〜7件で全テーマの約78〜82%を捕捉できます。閾値を0%まで厳しくすると、11〜14件で87〜89%になります。「何件で十分か」は、「どこまで拾えれば十分とするか」で決まります。
飽和だけでは人数を決められない
決まりません。情報の濃さ、多サイト調査、飽和概念への批判が、その限界を示しています。
ここまでの研究は、飽和に何件かかるかを測るものでした。その問いの立て方を問い直す流れもあり、3つ紹介します。
1. Information Power(情報の濃さ)で決める
Malterudら(2016)は、サンプルサイズを固定の数字でなく、サンプルが持つ情報の濃さ(Information Power)で決める枠組みを提案しました(Qualitative Health Research 26(13))。
情報の濃いサンプルなら少人数で足り、薄いサンプルなら多人数が要ります。濃さを決める要因は、目的の広さ、サンプルの特異性、理論の使用、対話の質、分析戦略の5つです。目的が狭く、対象者が目的に強く合致し、対話が深いほど、少人数で足ります。
2. 多サイト・多セグメントなら20〜40件
Hagaman & Wutich(2017)は、4つの調査サイト・132名のデータで検証しました(Field Methods 29(1))。
単一サイトの同質な集団なら、16件以下で飽和に達しました。一方、サイトを横断するメタテーマの特定には20〜40件が必要でした。対象が多様になると、必要な件数はGuestらの12件を大きく超えます。
3. 飽和は万能の基準か
Braun & Clarke(2021)は、飽和を基準にすること自体を批判しています(“To saturate or not to saturate?”、Qualitative Research in Sport, Exercise and Health 13(2))。
テーマは、データに埋まっていて発見されるものでなく、研究者が解釈を通じて生成するものだという立場です。この立場では、「テーマが出尽くしたら終わり」という飽和の発想は、彼らのリフレクシブ・テーマ分析と整合しません。
飽和は、特定の分析観に結びついた基準です。普遍のものさしではない、という指摘です。
問い・対象・理解の深さから人数を決める
条件を先に決め、対応するレンジを参照し、深さや多様性で補正する3つの手順で決めます。
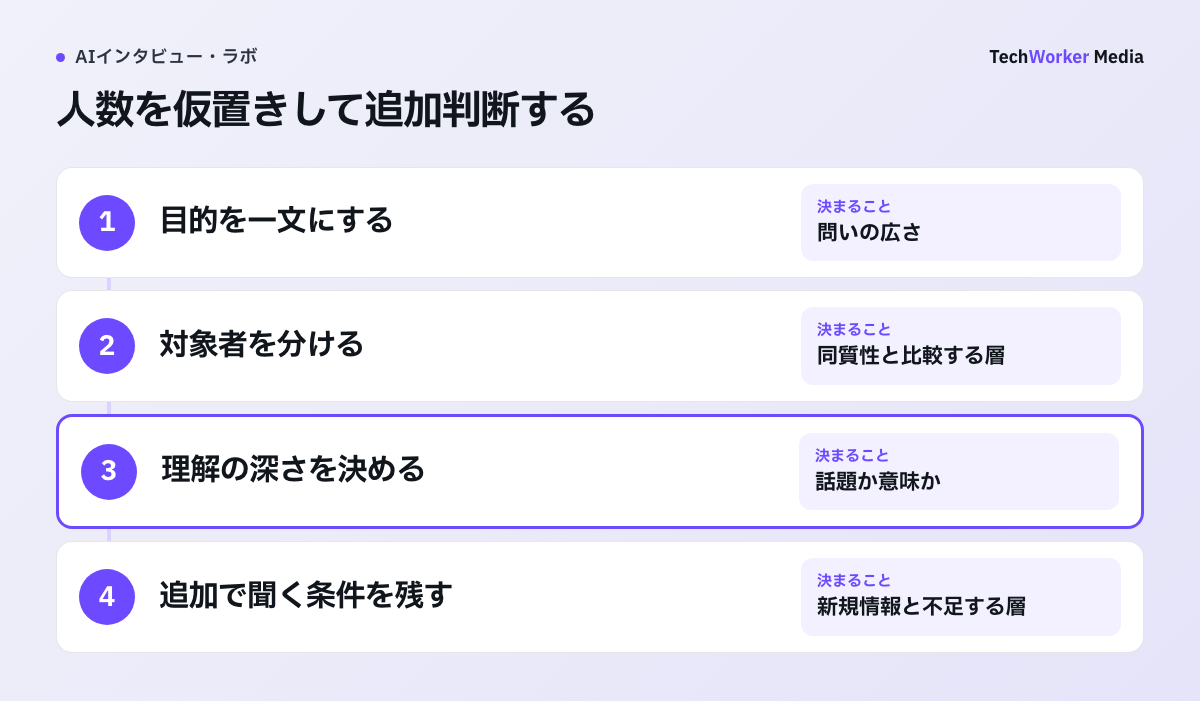
9〜17件、16〜24件、20〜40件は、条件の異なる研究の報告範囲です。各セグメントへ機械的に配る人数ではありません。計画時は目安として仮置きし、途中で得た新しい情報と、声が不足する層を見て追加判断します。採用した分析方法が飽和を基準にするかも、先に決めます。
どの数字にも条件が付いています。自分の調査の条件を先に判定し、それから対応するレンジを参照します。
- 3つの軸で条件を判定します。意思決定の問いの広さ、対象集団の同質性、求める理解の深さです。
- 条件に対応するレンジを参照します。同質な集団に狭い問いを構造化して聞くなら、9〜17件が最初の目安です。
- 条件に応じて補正します。意味まで理解したいなら16〜24件側へ、セグメントや拠点を横断するなら20〜40件側へ寄せます。
例として、「解約者はなぜ辞めたのか」を、単一プロダクトの直近解約者に構造化して尋ねる場合を考えます。最初の目安は9〜17件です。感情や文脈まで理解したいなら16〜24件側へ、プラン別・業界別の違いも見たいなら20〜40件側へ補正します。
数字を先に決めず、条件を先に決めるのが、この手順の要点です。
AIで聞ける人数と必要人数を分ける
AIで人数を増やせても、調査目的に合う人数の判断は残ります。研究レンジは計画の参考として使います。
近年のワーキングペーパー2本は、AIによる大人数の定性インタビューが可能になったと示しています(Geiecke & Jaravel、Chopra & Haaland)。
本記事で参照するのは公開された研究版です。Geiecke & Jaravelは、2026年10月3日に確認したCEPRページでDiscussion Paper(研究討議論文)と表示されています。採択状況は断定しません。
CoeSignal(株式会社TechWorkerが提供するAIインタビュープラットフォーム)のような仕組みでも、数十名規模の深掘りを短期間で回せるようになりました。
では、「何人で十分か」という問いは消えたのでしょうか。「飽和論が無効になった」と主張する査読済み研究は、現時点で確認できていません。
同質な集団への狭い問いなら、大人数に聞いても新しいテーマが序盤以降ほとんど増えない構造は変わりません。変わったのは、意味飽和(16〜24件)や多サイト調査(20〜40件)の規模に、届きやすくなったことです。
人数を増やせる今こそ、目的・同質性・深さから必要数を見積もる枠組みが、設計の拠り所になります。
人数設計を誤る3つの転用
12件を無条件に使う、コード飽和で足りたと考える、同質集団の数字を横断調査に当てはめるの3つです。
- 「12人で十分」を無条件に使う。著者自身が、汎用のサンプルサイズとして使うべきではないと警告しています。
- コード飽和の9件で、意味まで分かったと考える。意味飽和には16〜24件かかりました。
- 同質な集団の数字を、多サイト調査に当てはめる。単一サイトは16件以下でも、サイトを横断するメタテーマには20〜40件が必要でした。
調査条件別の研究レンジ
条件ごとに研究の目安が異なり、固定の数字は1つもありません。表で確かめてください。
| 調査の条件 | 研究が示す目安 | 根拠 |
|---|---|---|
| 同質な集団 × 狭い問い × 構造化した聞き方で、テーマの一覧を得たい | 9〜17件で飽和という実証報告が並ぶ(12件はその中央付近) | Guest et al. 2006 / Hennink & Kaiser 2022 |
| 各テーマの意味・ニュアンスまで理解し切りたい | コード飽和(9件)では足りず、16〜24件 | Hennink, Kaiser & Marconi 2017 |
| 複数のセグメント・拠点・文化を横断して共通テーマを見たい | 20〜40件 | Hagaman & Wutich 2017 |
| 探索的な広い問い/理論なし/対話が浅くなりそう | 固定数でなくInformation Powerの5要因で増減を見積もる | Malterud et al. 2016 |
| リフレクシブ・テーマ分析など、解釈を生成する立場の分析 | 飽和を基準にしない。分析の目的と解釈の十分さで判断する | Braun & Clarke 2021 |
表:調査の条件別に見たサンプルサイズの目安(各研究の報告値に基づく整理)。
よくある質問
条件次第です。「12人で飽和」の出どころであるGuestらの2006年研究は、条件下の結果でした。同質な集団に、狭い目的で、構造化されたガイドを使って聞く調査です。著者自身が、12件を汎用のサンプルサイズとして使うべきではないと警告しています。多様な集団や複数拠点にまたがる調査、意味の深い理解を目指す調査では、より多くの件数が必要になると後続研究が示しています。
Hennink & Kaiser(2022)は、飽和を実証的に検証した23論文をレビューしました。実データに基づく研究は、インタビュー9〜17件、フォーカスグループ4〜8回で飽和に達していました。ただしレビュー著者自身が、対象研究は同質な集団・狭い目的に偏っていると明記しています。万能の推奨値としては扱えません。何を飽和と数えるかでも答えは変わり、同じ25件のデータでコード飽和は9件、意味飽和は16〜24件でした。
聞き手がAIになっただけで、必要人数の判断を省けるとは言えません。変わったのはコスト構造です。近年のワーキングペーパー(Geiecke & Jaravel、Chopra & Haaland。確認した公開版)は、AIによる大人数の定性調査の実現を示しています。「飽和論が無効になった」と主張する査読済み研究は現時点で確認できていません。人数を増やせるようになった今も、目的・集団の同質性・求める深さから必要数を考える枠組みは有効です。
調査計画に残す追加判断の条件
計画書には初期人数と追加条件を分けて書きます。同質な集団へ狭い問いを聞くなら、9〜17件を仮置きできます。意味の細部まで理解する場合や、拠点・職種を比べる場合は、その範囲を上限として扱いません。
- 誰に、何を決めるために聞くか。
- コード飽和と意味飽和のどちらを見るか。
- どのセグメントの声が不足したら追加するか。
- 新しい情報が何件続けて出なければ止めるか。
実査中にこの記録を更新します。最終件数は、最初に置いた数字でなく、追加と終了の判断履歴で説明します。
参考文献
- Guest et al. 2006(How Many Interviews Are Enough? Field Methods, 18(1), 59-82)journals.sagepub.com
- Hennink & Kaiser 2022(Sample sizes for saturation in qualitative research: A systematic review of empirical tests. Social Science & Medicine, 292, 114523)pubmed.ncbi.nlm.nih.gov
- Hennink, Kaiser & Marconi 2017(Code Saturation Versus Meaning Saturation. Qualitative Health Research, 27(4), 591-608)pmc.ncbi.nlm.nih.gov
- Malterud et al. 2016(Sample Size in Qualitative Interview Studies: Guided by Information Power. Qualitative Health Research, 26(13), 1753-1760)pubmed.ncbi.nlm.nih.gov
- Hagaman & Wutich 2017(How Many Interviews Are Enough to Identify Metathemes in Multisited and Cross-cultural Research? Field Methods, 29(1), 23-41)eric.ed.gov
- Guest, Namey & Chen 2020(A simple method to assess and report thematic saturation in qualitative research. PLOS ONE, 15(5), e0232076)journals.plos.org
- Braun & Clarke 2021(To saturate or not to saturate? Qualitative Research in Sport, Exercise and Health, 13(2), 201-216)tandfonline.com
- Geiecke & Jaravel(Conversations at Scale. CEPR DP19705、公開研究版)cepr.org
- Chopra & Haaland(Conducting Qualitative Interviews with AI. SSRN 4572954、公開研究版)papers.ssrn.com