
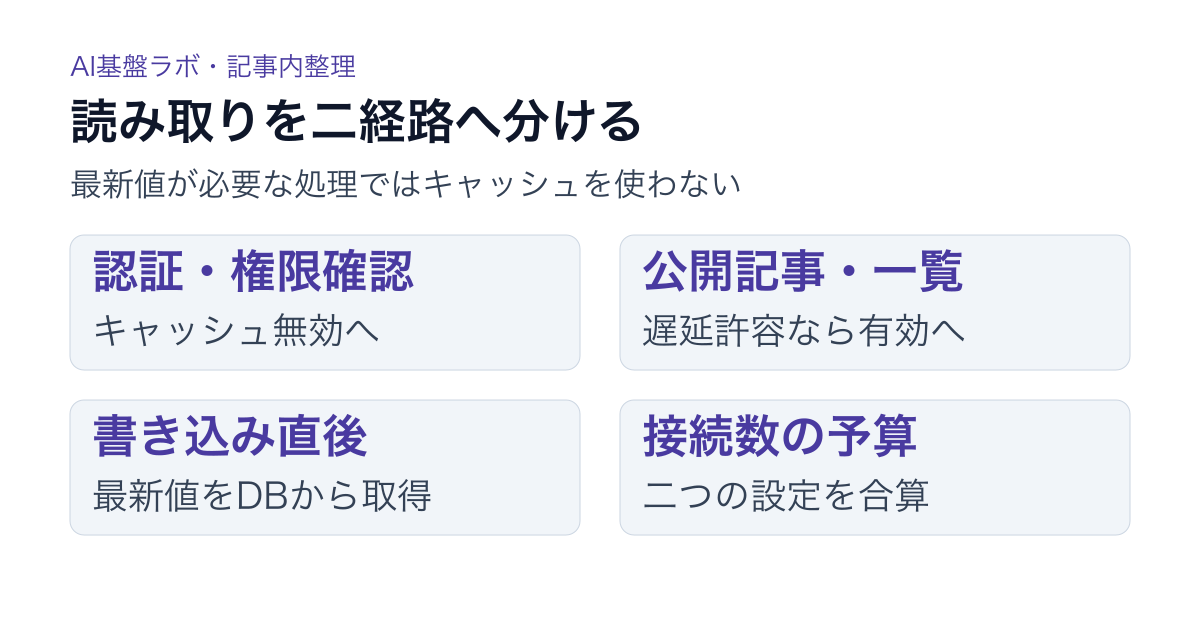
結論は、キャッシュを後から有効にすることです
Cloudflare Workersから既存のPostgreSQLへ接続する場合、Hyperdriveはキャッシュを無効にした状態から導入するのが安全です。まず接続をHyperdriveへ通し、データベースのクライアントをリクエストごとに作る構成へ直します。接続プールが枯れないことを確認してから、多少古い値を返しても業務上問題のない読み取りだけをキャッシュ対象へ移します。この順序なら、接続障害とデータ鮮度の問題を分けて調査できます。
Hyperdriveは、Workerに近いエッジで接続を受け、接続先データベースの近くに接続プールを置きます。Cloudflareは、通常のデータベース接続ではTCP、TLS、データベース認証に合計7回の往復が発生し得ると説明しています[1][2]。ただし、Hyperdriveを通せばすべての処理が速くなるわけではありません。1回のリクエストで問い合わせが1回だけなら、配置を変えても処理全体の遅延が改善しない場合があります。問い合わせを順番に何度も実行する処理では、距離による遅延が積み上がるため、データベースに近い配置を検討します[1]。
クライアントはリクエストごとに作ります
Workerの大域領域にデータベースのクライアントや接続プールを置くべきではありません。Workersはリクエストをまたぐ入出力を許さないため、以前のリクエストで作った接続を再利用すると、古い接続の参照や実行時エラーにつながります。Cloudflareは、fetchやqueueなど各処理の中でクライアントを作るよう案内しています[2]。接続先側の再利用はHyperdriveが担うので、アプリケーション側に長寿命の接続プールを重ねる必要はありません。
Durable Objectsでは、オブジェクトが長く生きるからといって接続を開いたままにしないことが重要です。開いている間はHyperdriveの接続枠を占有します。長いトランザクションも、完了まで接続を返しません。トランザクション内にはLLM APIの呼び出し、外部ツール、重い計算を入れず、データベース上で同時に確定させる処理だけを短く閉じます[2]。2026年9月26日の確認時点では、接続数の上限は無料プランで約20、有料プランで約100ですが、分散システムの可用性を優先して一時的に超える場合があります[6]。接続先データベースの上限には余裕を持たせる必要があります。
読み取り鮮度を二つの接続設定に分けます
Hyperdriveの問い合わせキャッシュは既定で有効です。既定のmax_ageは60秒、stale_while_revalidateは15秒です[3]。アプリケーションが書き込んでも、関連する読み取りキャッシュは自動で消えません。更新直後に同じSELECTを実行すると、期限内の古い結果が返る可能性があります。
対策は、同じデータベースに二つのHyperdrive接続設定を用意することです。認証、セッション、権限、請求、管理設定、書き込み直後の確認には、--caching-disabledで作成したキャッシュ無効の接続を使います。公開記事、商品一覧、検索結果など、短い遅延を許容できる読み取りだけをキャッシュ有効の接続へ流します[3]。二つの接続設定は、それぞれ接続先への接続枠を持つため、設定ごとではなく合計数で接続予算を管理します[3]。ORMや認証ライブラリがSQLを内部生成する場合も、鮮度が必要な機能にはキャッシュ無効のクライアントを渡します。
ローカルの合格を本番の合格にしません
通常のwrangler devでlocalConnectionStringを使うと、WorkerはHyperdriveを通らず、データベースへ直接接続します。この状態ではHyperdriveの接続プールも問い合わせキャッシュも働きません[4]。ローカル試験で書き込み直後の読み取りに成功しても、本番で同じ鮮度になるとは限りません。
本番公開前には、本番とは別のデータベースを使ってリモート環境で検証します。キャッシュ有効の経路では、書き込み直後、max_ageの期間内、再検証中の各読み取り結果を確認します。接続経路では、同時リクエスト、長時間のトランザクション、接続先の停止、接続拒否を再現します。wrangler dev --remoteはCloudflare上で動き、接続先への書き込みも実際に発生するため、本番データベースを向けたまま試してはいけません[4]。
監視は問い合わせ時間だけで終えません
Hyperdriveは、問い合わせ時間と接続時間に加え、キャッシュの状態、使用中の接続数、空き枠、接続待ちのクライアント数を公開しています[5]。平均の問い合わせ時間が短くても、接続待ちが増えていれば、接続プールの枯渇が近づいています。キャッシュの命中率が高くても、権限や請求の読み取りがキャッシュ経路へ流れていれば設計上の問題です。
公開判定では、同じ問い合わせ群と負荷条件で、キャッシュ状態、接続待ちの最大値、問い合わせエラー、接続時間を比較します。指標の保持期間は31日なので、変更前の基準値を先に保存します[5]。Neonは自社試験で世界各地からのSELECTが約9倍速くなったと報告していますが、同社の問い合わせと環境による計測です[7]。PlanetScaleは温存した接続とQuery Insightsの組み合わせを案内し[8]、Prismaもリクエスト内でクライアントを作る実装を示しています[9]。他社の倍率ではなく、自社の問い合わせと整合性要件で成否を判断します。
Hyperdriveにも直せない問題があります
Hyperdriveは、遅いSQL、不足したインデックス、長すぎるトランザクション、データベースの容量不足を直しません。問い合わせキャッシュも、認可や整合性の代わりにはなりません。接続プールが埋まったときに上限を増やすだけでは、長時間のトランザクションを温存して障害を先送りする場合があります。
安全に導入するには、リクエスト内でのクライアント生成、短いトランザクション、鮮度別の接続分離、リモート環境での鮮度試験、接続待ちの監視が必要です。最初にキャッシュを切り、正しく接続できる状態を作ります。その後、鮮度を失っても問題のない読み取りだけにキャッシュを適用します。
根拠資料
資料確認日:2026年9月26日。本文中の手順例は編集部の提案で、導入効果の実測値ではありません。