AI Gatewayでprovider別の失敗、遅延、token、推計cost、fallbackを追い、機密payloadを保存しすぎない本番観測設計を解説します。
観測対象をrequest単位へ揃える
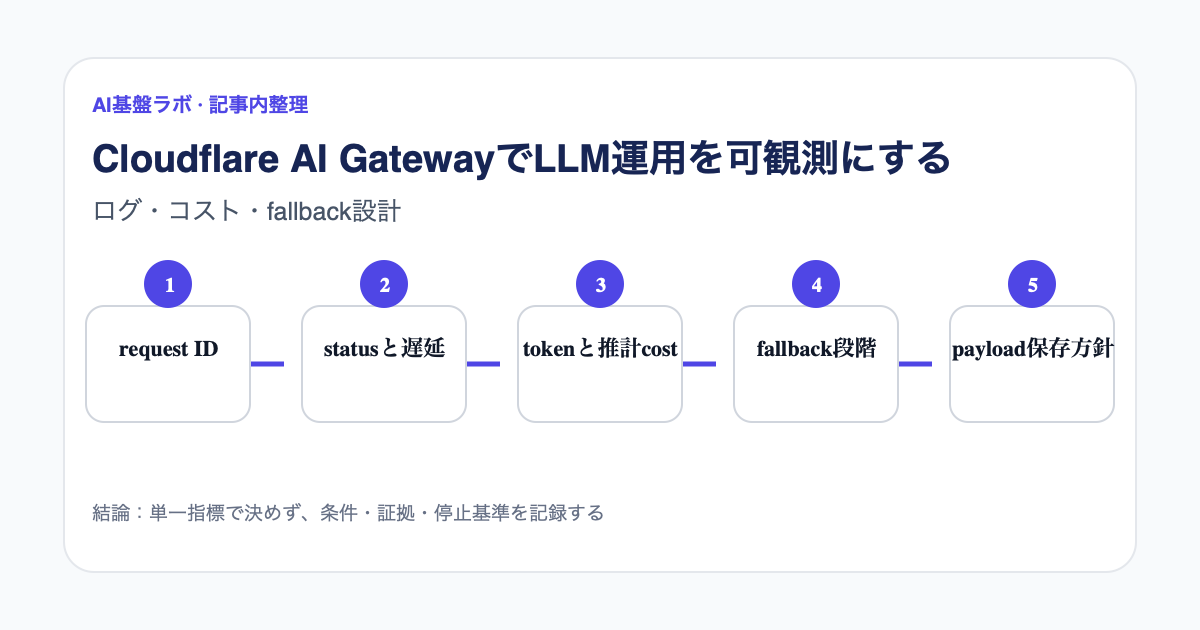
LLM applicationではHTTP 200でも、形式不正、tool call失敗、fallback、再試行による費用増が起きます。AI Gatewayはrequest、token、cost、duration、provider、statusなどを集約します[1]。application、gateway、providerへ同じrequest IDを通し、最終応答だけでなく途中の失敗も追えるようにします。
成功率と遅延を分解する
成功をprovider到達、provider応答、schema妥当、application採用へ分けます。遅延もgateway、provider、再試行、後処理へ分解します。全体平均だけでなくp50、p95、timeout、rate limitをproviderとmodel別に見ます。AI Gateway analyticsはrequest、token、cost、error、latencyを確認できますが、品質判定はapplication側の評価と接続する必要があります[2]。
payloadを保存しない観測を既定にする
loggingはpromptとresponseまで保存でき、既定で有効な場合があります[3]。個人情報や顧客文書を扱うrequestは、cf-aig-collect-log-payloadをfalseにし、metadataだけ残す選択ができます。本文が必要なdebugは対象、閲覧者、保持期限を限定します。log容量上限に達すると新規logが止まる構成もあるため、削除・export方針を先に決めます。
costは推計と請求を分ける
model、provider、token、custom metadataで用途別に集計します。custom metadataへ氏名やメールを入れず、teamやfeatureの疑似IDを使います。spend limitsのcostはtokenと価格に基づくbest-effort推計で、正確な請求はprovider dashboardを参照するようCloudflareが明記しています[4]。月次で推計と請求を照合します。
fallbackを一段ずつ観測する
fallbackはerrorまたは設定したtimeoutで次のproviderへ移り、cf-aig-stepで成功した段階を確認できます[5]。主provider失敗をfallback成功へ埋め込まず、段階別に数えます。fallbackでmodelや価格、data処理先が変わる場合は、品質・法務・契約条件も再確認します。まず一つの低risk機能でbaselineを取り、一つのfallbackだけを追加します。
適用限界
AI Gatewayを通すだけで可用性やcostが必ず改善するわけではありません。observabilityは原因を見つける手段であり、retry storm、cacheのtenant混在、provider障害を自動で解消しません。limitsと製品仕様は更新されるため、公開時点の公式文書を再確認し、重要値は自社monitorでも保持します。
最小dashboardとalert
最初のdashboardはrequest数、end-to-end成功率、provider error率、p50・p95 latency、token、推計cost、cache hit、retry、fallback段階に絞ります。model別とfeature別にfilterできるmetadataを付けますが、個人や顧客を直接識別する値は使いません。business成功はapplication側eventとして別に持ち、gateway成功と混ぜません。
alertは一時的な変動で鳴り続けないよう、母数と時間窓を持たせます。たとえばprovider error率だけでなく件数、p95 latency、fallback率の組合せを見ます。cost alertではtoken増加、model変更、retry増加を切り分けます。spend limit到達による429は障害として観測し、安価modelへの切替が起きた場合も利用者影響を確認します。
runbookには、どのchartを見るか、どのrequest IDを追うか、provider statusをどこで確認するか、payloadなしで調査できないときの承認者、fallback停止条件、復旧後の戻し方を記載します。重要requestをsampleで再生する場合は、実payloadを使わず匿名化fixtureを優先します。
月次reviewではGateway集計、provider請求、applicationの利用数を照合します。差が大きい場合は価格table、cached token、image・audio課金、失敗request、時差、custom cost設定を確認し、数字を無理に一致させません。
一次情報と確認範囲
確認日:2026年9月21日。海外の制度・製品仕様・研究結果は日本へそのまま適用せず、国内法・契約・対象条件を別途確認してください。