AI基盤で複数のLLMを使う理由は、単に「安いモデルへ逃がす」ためではありません。要約、分類、検索クエリの生成、顧客向け回答、外部操作の計画では、求める精度、遅延、入力形式、許容できる失敗が違います。障害時のfallback(代替経路)も、応答が返っただけでは成功といえません。別modelが返したJSONを下流が読めるか、tool呼び出しを続けてよいか、利用者へ「処理済み」と見せてよいかを決めて初めて、切替は運用できます。
結論は、modelをAPIの内部実装として隠し切ろうとせず、業務ごとに「出力契約」「許可された行動」「品質判定」「切替後の扱い」を定義することです。ルーティングはその契約を満たす候補から選び、fallbackは高品質な代替回答を約束する仕組みではなく、障害をどう安全に扱うかという設計にします。
最初に、仕事ではなく契約でmodel候補を分ける
「問い合わせ対応は小型model、難問は大型model」のような粗い分類では、後から例外が増えます。代わりに一つの呼び出し単位で、入力の形式、必要な出力形式、正しさの基準、最大遅延、単価上限、外部操作の可否を記述します。たとえば文書の一次分類は、定めたラベルだけを返し、根拠を保存し、未分類を返せばよい。対して経費申請を下書きするagentは、金額・勘定科目・根拠を構造化して返し、送信はしない、と契約します。
Google Vertex AIには、requestの内容とquality、balanced、costという優先度に基づいてmodelを選ぶauto routingと、model名を指定するmanual routingがあります。製品の自動選択を利用する場合にも、事業者が決めるべきなのは「どの用途で何を優先するか」と、選択結果を観測できることです。研究でもLLM routingは、問い合わせごとに候補modelの性能とcostのトレードオフを扱う問題として評価されます。ただし、ベンチマークの平均順位を自社業務の正解率と取り違えません。
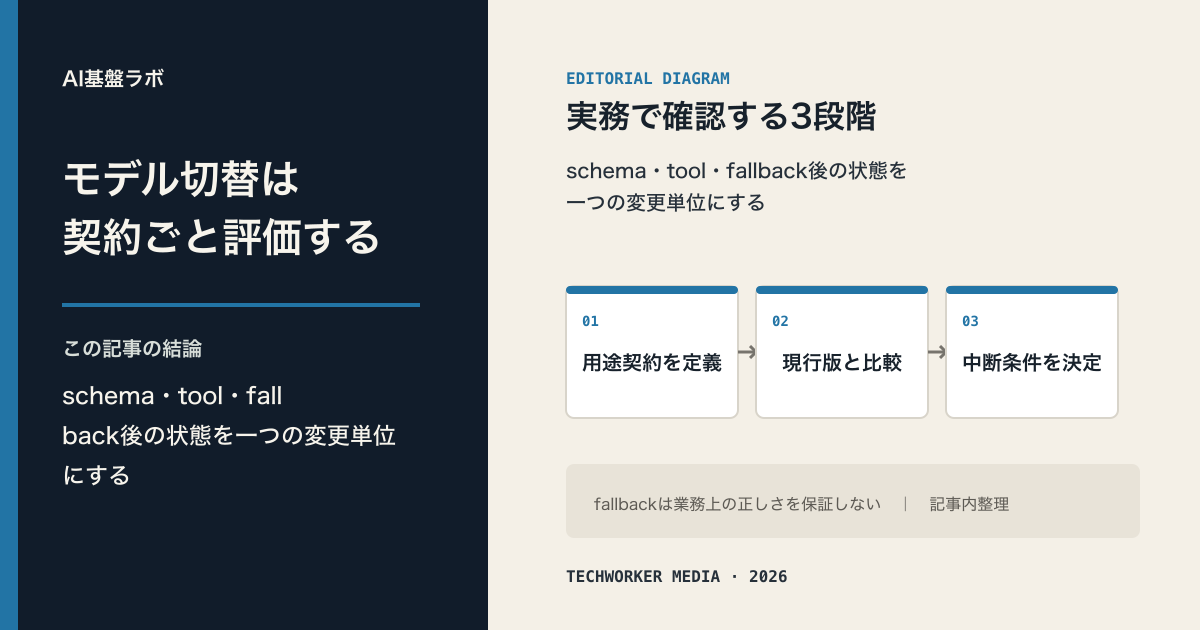
model ID、schema、toolを一つの変更単位にする
切替時に壊れやすいのは文章のうまさだけではありません。JSON schemaへの適合、function callingの引数、拒否・確認の出し方、context window、画像や音声の扱い、token上限も変わります。modelの別名だけを指定していると、提供側の更新で同じrequestが別の振る舞いになる可能性があります。用途ごとに実際に評価したmodel ID、prompt版、tool定義版、parser版を記録し、変更は一組として評価します。
これは特定の提供者に限りません。Anthropicはdeprecated modelを退役日より前に新modelでテストし、速やかに推奨replacementへ更新するよう案内しています。つまり、modelの退役はインフラ運用の予定作業です。切替候補をあらかじめ一つだけ持ち、正常系・情報不足・長文・tool失敗のケースを現行版と比較します。AIエージェントの品質劣化を止めるで扱った評価セットを、model契約の回帰テストに使えます。
fallbackは「成功した応答」ではなく「継続可能な状態」を返す
Cloudflare AI Gatewayは、errorまたは設定したtimeoutで別provider・modelへfallbackでき、どの段階が応答したかをcf-aig-step headerで示します。これは可用性の実装に有用です。しかし、一次modelが途中までstreamした後の切替、tool callを既に一度実行した後の再実行、同じ入力を別modelへ送ることのデータ条件は、gatewayだけでは判断できません。
そこでfallbackの結果を三つに分けます。第一に、分類や要約のように、schema検証と最低品質検査を通れば代替結果を採用できる処理。第二に、回答案のように、代替結果は返せても「代替modelで生成」と記録し、後続の自動送信は行わない処理。第三に、支払い、削除、公開、権限変更のように、modelが変わった時点で中断し、人または再試行キューへ渡す処理です。fallbackを付けるほど、元の実行と代替実行を同一視しないことが重要になります。
外部操作を伴うagentでは、request IDと操作の冪等性キーをmodel選択とは別に持ちます。そうしないと、timeoutが「実行されなかった」のか「実行済みだが応答を失った」のか区別できず、代替modelが二重送信する危険があります。AIエージェントの同時実行を制御するのように、確定した操作結果を状態として保持してから次のmodelへ渡します。
ルーティングの根拠を、requestごとに残す
採用したmodel名だけでは、後からcost増、品質低下、規約変更を説明できません。用途ID、route ruleの版、候補集合、実際のproviderとmodel、fallback段階、入力・出力token、遅延、schema検査、評価または人の修正結果を、本文を最小化した形で記録します。Cloudflareのdynamic routeは、実際に使ったmodelとproviderをresponse metadataで返します。この種の情報をアプリ側の業務IDと結び付けると、特定routeだけを比較できます。
最初から学習型routerを導入する必要はありません。最小構成は、業務契約ごとに固定modelを一つ決め、影響の低い処理だけに明示的な代替候補を一つ置くことです。週次またはmodel更新時に、同じ評価セットで現行・候補を比べます。OpenAIが公開したdeployment simulationも、過去の利用文脈で候補modelを再生成して比較する考え方を示しますが、希少な失敗を検出できず、red teamや標的評価を補完すると明記しています。実データを使うときは、同意、マスキング、保存範囲を別途設計してください。
導入時の最小チェックリスト
- 呼び出しごとに、出力schema、禁止操作、最大遅延、cost上限を定義したか
- 評価済みのmodel ID、prompt、tool定義、parserを一組でversion管理しているか
- fallback後に自動採用、要review、中断のどれにするかを処理ごとに決めたか
- 外部操作に、modelをまたいでも同じ冪等性キーと確定状態を使っているか
- 実際に選ばれたprovider、model、route版、fallback段階を後から追えるか
TechWorkerでは、AI基盤のmodel選定を価格表の比較で終わらせず、業務ごとの出力契約、評価、障害時の中断条件までを設計します。新modelやproviderを試せる速度を保ちながら、顧客業務に影響する自動化だけは予測可能に変更できる状態を支援します。
限界と確認範囲
自動routingは、個々の業務に対する正解や法的適合を保証しません。model間に同じ入力・出力・tool仕様があるとは限らず、fallbackで返った自然な文章が正しいとも限りません。providerの価格、利用可能なmodel、退役日、routing機能の対象は更新されます。高影響の操作ではfallbackを可用性対策として自動継続させず、実行時認可と人の承認を別に置き、導入時に公式仕様と契約条件を確認してください。
一次情報と確認範囲
確認日:2026年9月12日。製品仕様・制度は更新されるため、導入時はリンク先の最新版を再確認してください。海外の制度・職業規範は日本へ直接適用せず、相違点と限界を本文に明記しています。
- Vertex AIのrouting configは、auto modeまたはmanual modeを選べ、auto modeにはquality、balanced、costの優先度がある
- LLMRouterBenchは、問い合わせを候補LLMへ割り当てるroutingを、性能重視と性能-cost trade-offの両面で扱う
- Anthropicはdeprecated modelの退役前に新modelでアプリをテストし、推奨replacementへ更新することを案内する
- Cloudflare AI Gatewayはerrorまたはtimeout時にmodel/provider fallbackを実行でき、成功した段階を`cf-aig-step`で返す
- Cloudflare dynamic routeは実際に選ばれたmodelとproviderをresponse metadataで確認できる
- Cloudflare AI Gatewayは多数のproviderを扱い、logging、caching、rate limiting、retry、fallbackを提供する
- OpenAIのdeployment simulationは本番に近い文脈で候補modelを比較する補助だが、希少な失敗にはred team等が必要と説明する