AIエージェントは、modelを替える、system promptを一行直す、検索対象を増やす、toolの戻り値を変えるだけで振る舞いが変わります。個別のデモがうまく動いたことと、既存業務で品質を保てることは別です。とくにtoolを呼び、複数手順を進めるエージェントでは、出力文だけでなく、どの順序で何を実行したかまでが品質になります。
品質を安定させる出発点は、「よさそうな回答を選ぶ」ことではなく、変更前後で同じ業務を比較できる評価セットを持つことです。OpenAIのEvalsは、評価をデータソースと採点基準からなるテスト構造として扱います。Anthropicも、エージェント評価ではモデル単体ではなく、toolや複数ステップを含む環境までが結果を左右すると説明しています。
評価セットは、業務の失敗から作る
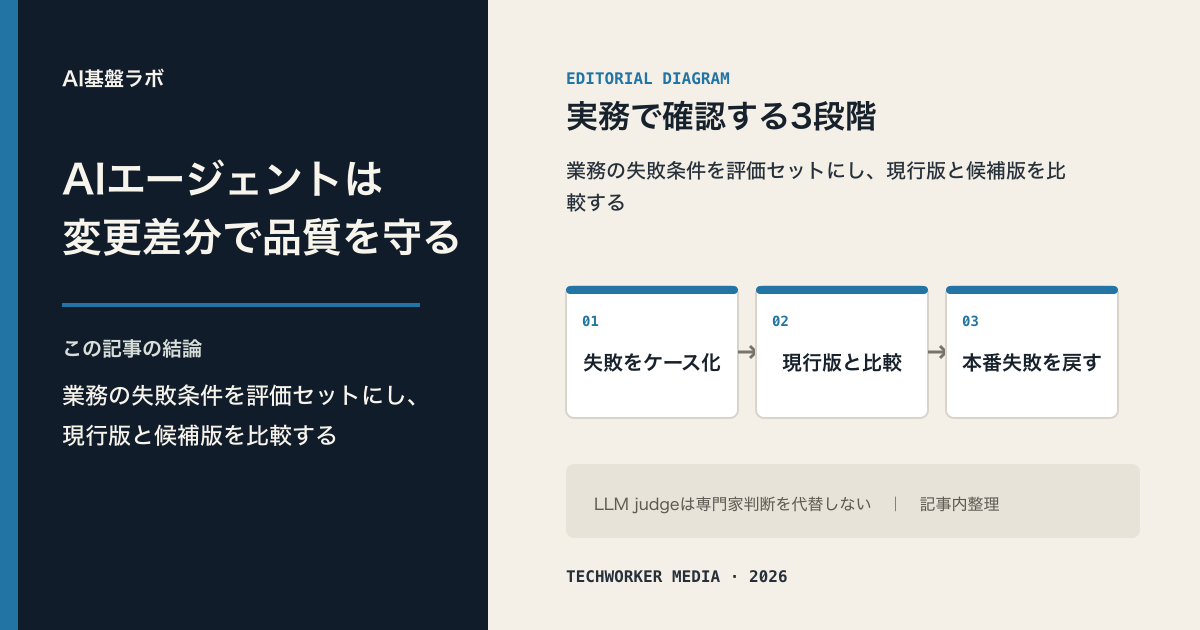
最初から一般ベンチマークを集める必要はありません。対象業務で「誤ると困る操作」を列挙し、入力、期待する状態、禁止する状態を一組にします。たとえば社内検索エージェントなら、正しい文書を根拠にする、権限外の文書を参照しない、根拠不足なら断定しない、が評価対象です。更新エージェントなら、更新内容が正しいことに加え、許可のない送信・削除を選ばないことが必要です。
一問一答の正解文だけを正本にすると、表現が異なるだけの妥当な回答を不当に落とします。逆に「役に立つか」だけでは、誤った根拠や危険なtool実行を見逃します。各ケースに、必須の根拠・必須の構造・禁止操作・人の確認が必要な条件を分けて記述します。業務の例外、過去の障害、利用者が修正した結果を、個人情報や秘密情報を除いた形で追加していくと、評価セットは実務に近づきます。
出力品質と行動品質を分けて判定する
評価は少なくとも二層に分けます。第一層は機械的に確かめられる条件です。JSON schema、必須フィールド、引用の有無、許可されていないtoolを呼ばないこと、上限回数を超えないことなどは、LLMに採点させず決定的な検査にします。
第二層は、人間の判断を含む品質です。根拠が質問に答えているか、要約が重要な例外を落としていないか、顧客向けの文面が誤解を招かないかを、rubric(採点基準)で見ます。LLMをjudge(採点役)にすると反復比較は速くなりますが、Google Cloudの評価ガイドは、judgeの評価を人の評価データと比較して適合を確認する手順を示しています。OpenAIも、automated graderは専門家による評価を置き換えるほど信頼できるものではないと説明しています。
したがって、機械判定は「必須の失敗を止める」、LLM judgeは「傾向を素早く比較する」、人のレビューは「業務上の正しさを校正する」と使い分けます。一つのスコアだけをreleaseの条件にしません。
リリースは現行版との比較で決める
新しいmodelやpromptを評価するときは、候補だけを採点しても判断できません。同じ評価セットを現行版と候補版にかけ、どのケースが改善し、どのケースが悪化したかを差分で見ます。高影響の禁止操作、権限境界、根拠のない断定は、平均点が上がっていてもreleaseを止める条件にします。
評価対象には、正常系だけでなく、情報不足、矛盾した指示、長い入力、toolの一時失敗、承認が来ない場面を含めます。これは「難しい問題を増やす」ためではありません。本番で失敗したときに、安全に停止・引継ぎできるかをrelease前に確かめるためです。NIST AI RMFも、AIシステムはdeployment前だけでなく運用中も、測定・検証・文書化することを求めています。
本番のtraceを次の評価へ戻す
評価セットだけでは、利用者が実際に出会う新しい例外は拾えません。AIエージェントの障害を追跡できるログ設計のように、実行ID、tool、エラー、版を追える状態を作り、失敗したrunを次の候補ケースへ変換します。ただし、本番traceをそのまま評価データへ複製すると、個人情報や営業秘密を別用途へ広げる恐れがあります。収集範囲、マスキング、閲覧者、保持期限を先に決めます。
RAGの更新を止めないためのversion管理も同じです。文書の版や検索indexを変えるなら、エージェント側の評価結果が、どの知識版に対するものかを残します。評価がよかった理由・悪かった理由を後から比較できなければ、改善は再現できません。
導入時の最小チェックリスト
- 業務ごとに、成功、禁止操作、停止・引継ぎ条件を定義したか
- 現行版と候補版を同じケース・同じ実行条件で比較したか
- schemaや権限などの決定的検査を、LLM judgeへ丸投げしていないか
- judgeの判定を、業務担当者のレビューで定期的に校正するか
- 本番の失敗ケースを、秘密情報を最小化して評価セットへ戻せるか
TechWorkerでは、AIエージェントの導入時に、業務の成功条件を評価ケースへ翻訳し、変更を安全に出せるrelease判定と運用監視を設計します。モデル選定だけでなく、現場が「どの変更なら出してよいか」を判断できる基盤まで支援します。
限界と確認範囲
評価セットは、収録した業務しか直接は保証しません。小さすぎるセットは特定のpromptやmodelに合わせ込まれ、未知の入力での品質を保証できません。LLM judgeにも偏りや誤判定があり、人の判断を代替しません。高影響の外部操作では、評価で許容されたことを認可・承認の代わりにせず、実行時の境界を別に置いてください。
一次情報と確認範囲
確認日:2026年9月11日。製品仕様・制度は更新されるため、導入時はリンク先の最新版を再確認してください。海外の制度・職業規範は日本へ直接適用せず、相違点と限界を本文に明記しています。
- OpenAI Evalsは、データソースと採点基準を持つ評価を作成し、modelやparameterごとに実行できる
- エージェントの評価結果はmodelだけでなく、toolや複数手順を含む環境・harnessに依存する
- Anthropicはagent evalで静的解析、browser agent、LLM judgeを組み合わせる例を示す
- LLM-based gradingは高速・柔軟だが、採点方式は信頼性と拡張性を踏まえて選ぶ必要がある
- Googleのjudge model評価は、人の評価をground truthとして比較し、judgeの適合を確認する
- NIST AI RMFはdeployment前と運用中のTEVV、測定、文書化を扱う
- OpenAIの実務評価ではautomated graderを専門家評価の代替として扱わない