AI APIが429を返したとき、429なら指数バックオフだけを書いて終えると、本番では足りません。同じ429でも、数秒待てば通るレート制限、残高・月次上限が戻るまで通らない状態、ゲートウェイ側の利用上限で止めた状態があり、再試行の意味が異なるためです。利用者の再送、SDKの自動retry、Worker側のretry、Gateway側のretryが重なると、失敗したリクエスト自体が上流の負荷を増やし、待機列と請求を膨らませます。
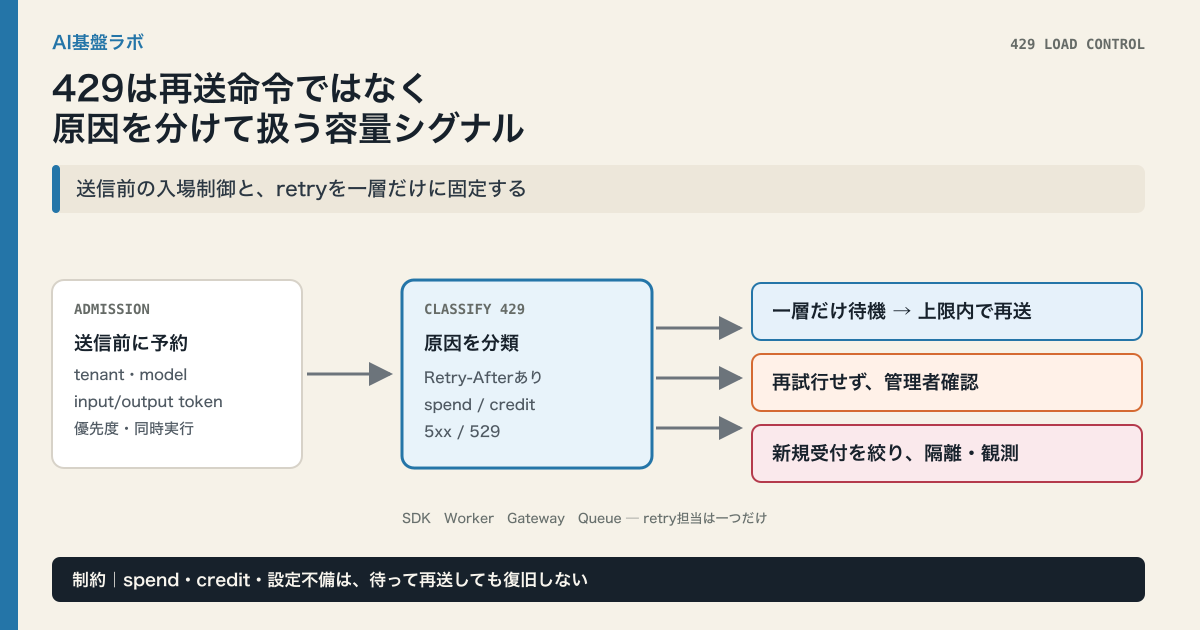
結論は、429をHTTP statusだけで扱わず、原因を分類してから入場制御・待機・失敗通知を選ぶことです。入口で利用者・tenant・モデル別に同時実行数とtoken見積りを予約し、上流のRetry-Afterがある短期制限だけを一層で再試行します。支出上限や恒久的な設定不備は再試行せず、明示的に停止します。本稿は9月3日のQueue/DLQ記事の「非同期ジョブの再配信」とは別に、オンライン推論を上流へ送る前後の負荷制御を扱います。
429は一種類の失敗ではない
IETFのRFC 6585は、429を一定時間に送ったrequestが多過ぎる状態と定義し、Retry-Afterを付けることを許容しています。しかし、誰を一人と数えるか、どの範囲で数えるかは規定していません。アプリはstatusだけから「10秒後なら必ず成功」と推測できません。
OpenAIは429が一時的なrate limitのほか、prepaid balanceやspend/usage limitでも起こり得ると説明します。Retry-Afterが有効なら少なくともその時間を待ち、なければjitter付き指数バックオフにしつつ、回数と総待機時間を制限するのが公式の案内です。失敗requestも分単位の制限へ寄与するため、即時再送は復旧策ではなく悪化要因になります。さらに公式SDKが対象エラーを自動retryするため、アプリ側で二つ目の無条件retry loopを足す前に、SDK設定を確認します。
Anthropicでも、Messages APIの制限はRPMだけでなく入力・出力token/minuteに分かれます。429でもtierの月次spend capではretry-afterがないことがあり、待って再送しても復旧しません。500、529、stream開始後のerror eventも別の扱いです。つまり「request数が余っているから通る」とは限らず、入力の長い会話や出力上限がtoken枠を消費している可能性を、request IDとproviderのエラー詳細で切り分けます。
retryは一層だけ、入場制御は送信前に行う
最小構成では、アプリのadmission controller(受付制御)が、tenant_id、モデル、推定input token、予約した最大output token、優先度を受け取り、上流へ送る前に判断します。ここでのtoken見積りは正確な請求額を当てるためではなく、同じtenantの大量送信が全体を詰まらせないためです。許可しない場合は、画面を長くspinさせず、待機・後で再試行・管理者確認のいずれかを返します。
retryを置く層は、SDK、Worker、AI Gateway、Queue consumerのうち一つに決めます。Cloudflare AI Gatewayは最大5回、一定・線形・指数のbackoffを設定できます。Gatewayをその担当にするなら、呼び出し元は「このrequestはGatewayが再試行済みか」を記録し、同じ失敗を別層で重ねません。書込みを伴うtool実行は、生成requestのretryと外部効果のretryを混ぜず、前者の再送前に実行済み状態を確認します。
Cloudflare AI Gatewayのrate limitはGatewayを通る全requestへ一律適用されます。そこで、対話回答・バックグラウンド要約・embedding投入を同じGatewayに置く場合は、低優先の大量処理が対話を飢餓させない値かを検証します。用途を分けられない初期段階でも、少なくともmetadataで用途・tenant・モデルを残し、429を一つの合計値で眺めないことが必要です。
停止する条件を先に定義する
実装上は、次の四分類で十分です。
- 待機して再試行: 有効な
Retry-Afterのある一時rate limit、または明示した短期の接続失敗。上限回数・総時間内だけ、一層で行う。 - 新規受付を絞る: request/tokenの残量が小さい、429が連続する、待機列が期限を超える場合。既存実行の再送より、低優先requestを遅延・拒否する。
- 設定・課金として停止: spend cap、credit不足、認証/入力不備。利用者には再試行ボタンではなく、管理者が確認すべき原因を返す。
- 隔離して調査: providerの5xx/529、異常な急増、同一tenantの連続失敗。request ID、内部run ID、モデル、予約token、返却headerを結び、本文やAPI keyは記録しない。
日本企業の法人導入では、事業部ごとの予算と、provider上では組織・project単位で掛かる上限が一致しないことがあります。海外providerのtierをそのまま「部門の利用可能量」と見なさず、社内のtenant/費目と上流projectを対応付けます。夜間の一括処理と営業時間の対話処理を同じ枠に置くなら、誰が優先され、止まったときに誰が判断するかを運用表へ書くことが、技術的なbackoffより先です。
限界と反証
この設計は上流の空き枠を保証しません。Retry-Afterがない429でも一時的に戻ることはあり、逆にheaderどおり待っても利用者の期限内に返せないことがあります。モデル切替は可用性対策になり得ますが、schema・tool・品質契約を満たす別モデルが確認済みの場合だけに限るべきです。特に外部送信や更新を伴うagentでは、429の再送が同じ外部効果を二度起こさないよう、冪等性と実行状態を別に確認してください。
導入時の最小チェックリスト
- SDK、Worker、Gateway、Queueのうち、retryを実行する層を一つに固定したか
- 429を
Retry-Afterありの一時制限、spend/credit、設定不備、上流過負荷へ分類できるか - request数だけでなくinput/output token見積りと同時実行数で受付を絞れるか
- provider request ID、内部run ID、モデル、予約量、結果分類を、本文を残し過ぎずに追えるか
- 対話・一括・embeddingなど異なる優先度の処理が、同じ枠を奪い合っていないか
情報図解
図版仕様(1200×675px): 濃紺背景に、左から右へ「受付 → 分類 → 実行 → 結果」の4列を配置する。分類列から、青のRetry-Afterありは「一層だけ待機→再送」、橙のspend/creditは「管理者確認」、赤の5xx/529は「隔離・観測」へ分岐。受付列にはtenant / model / input・output token予約 / 優先度の4タグ、実行列にはSDK・Worker・Gatewayのうち一つだけを発光させ、残り二つへ「retry禁止」の破線を引く。下部に「429 = 再送命令ではなく、容量シグナル」という結論を置く。
既存記事との差分・内部リンク
- Cloudflare AI Gatewayの安全なキャッシュ設計は、Gatewayで回答を再利用するときのprivacyと鮮度を扱う。本稿は、実際に429を受けたときの原因分類、入場制御、retry担当の一層化に限定する。
- Cloudflare QueuesでAIジョブを非同期化するは、非同期jobの再配信とDLQを扱う。本稿は、オンライン推論をproviderへ送信する前後の容量制御を扱う。
- AI基盤のモデル切替設計はfallback時の品質契約を扱う。本稿は、同じprovider・modelへ再送すべきかを429原因から判断する。
主検索意図は「AI APIの429を本番でどう分類し、再試行の増幅を防ぐか」であり、Gateway cache、Queue運用、model切替の検索意図・結論とは重複しない。CTAも429ログを起点にした負荷制御レビューへ限定する。
CTA
OpenAI/Anthropic/AI Gatewayが返した429ログを基に、retryの重複と容量配分を設計レビューしたい場合は、AI基盤の429再発防止を相談する。
一次根拠
- OpenAI: Troubleshooting API rate limits and 429 errors
- OpenAI: API reference — rate-limit headers
- Anthropic: Rate limits
- Anthropic: API errors
- Cloudflare: AI Gateway request handling
- Cloudflare: AI Gateway rate limiting
- IETF: RFC 6585 — 429 Too Many Requests
一次情報と確認範囲
確認日:2026年9月14日。製品仕様・制度は更新されるため、導入時はリンク先の最新版を再確認してください。海外の制度・職業規範は日本へ直接適用せず、相違点と限界を本文に明記しています。
- OpenAIの429はrate limitだけでなくcredit・spend/usage limitを示し得る。`Retry-After`を優先し、SDKの自動retryとの重複を確認する必要がある
- OpenAI APIはrequest IDとrequest/tokenのrate-limit headerを返す
- AnthropicのMessages APIはRPM、入力・出力token/minuteの制限を持ち、rate limit時は`retry-after`を返す
- Anthropicの429には`retry-after`を持たないtier spend capがあり、SDKは一時失敗を既定で2回retryする
- AI Gatewayは失敗requestを最大5回retryでき、待機時間とbackoff方式を設定できる
- AI Gatewayのrate limitは当該Gatewayを通る全requestへ均一に適用される
- RFC 6585は429を過剰requestと定義し、`Retry-After`を許容するが、利用者の識別・計数方法は規定しない