合成ペルソナを自然な文章で評価せず、実回答のholdout、分布、segment差、再実行、反対事例で利用範囲を決める方法を解説します。
自然な文章は妥当性の証明ではない
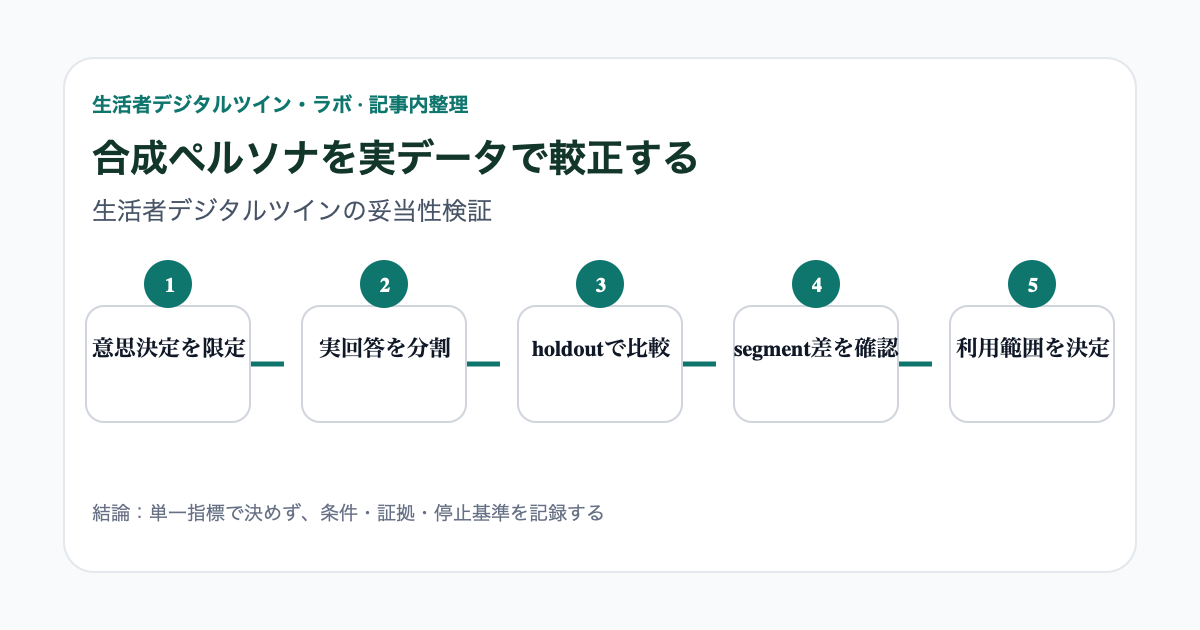
生成AIへ人物像を与えると、もっともらしい回答はすぐ作れます。しかし人間らしく読めることと、実在生活者の判断を再現できることは別です。商品選択、価格受容、message評価など一つの意思決定を決め、見ていない実dataへどこまで合うかを測ります。
較正用とholdoutを分ける
実回答をすべてpersona作成へ使うと、後から性能を測れません。profile構成やprompt調整に使う較正dataと、最終評価だけに使うholdoutを分けます。Stanfordの研究は1,052人のinterviewやsurveyを基にagentを作り、別のGeneral Social Survey項目、性格尺度、実験課題で比較しました[1]。この結果は特定条件の研究であり、万能性の証明ではありません。
平均ではなく分布とsegment差を見る
全体平均が合っても、全員が同じ回答へ寄れば少数意見を消します。選択割合、回答分散、年代・経験・態度別の差、理由の種類、同じ質問を繰り返したときの一貫性を見ます。2026年のPNAS研究は、少ない属性だけで条件付けた合成dataでは統計的realismが低下し、より豊富なcontextが改善の手掛かりになると報告しました[2]。
反対証拠を主な評価対象にする
一致例だけでなく、外した質問、特定segmentだけ逆転した項目、根拠のないもっともらしい理由を先に記録します。Columbia Business Schoolの研究は、digital twinがbase modelよりわずかに改善しても、人間回答との相関が弱く、stereotypingやrepresentation biasなどの歪みを示したと報告しています[3]。失敗例は排除せず、禁止用途を決める証拠にします。
再実行とmodel変更で結論を揺らす
model、prompt、temperature、実行日を記録し、同じholdoutを複数回実行します。順位、方向、segment差が変わる場合は、単独判断へ使いません。Argyleらの研究は人口統計的条件付けでsubgroup分布を模擬する可能性を示しました[4]が、対象data、model、時点に依存します。自社顧客へ外挿する前に再較正します。
適用限界
合成ペルソナは仮説発散、質問候補、edge caseの探索には使えますが、市場規模、個人の購買、金融・健康・雇用など高影響判断を単独で決めません。使える範囲、許容誤差、再確認日、停止条件を記録し、実在生活者の調査と行動dataで最終確認します。
較正表に残す項目
一行を一つの検証taskとし、対象商品、判断、対象segment、実data期間、較正data、holdout、model、prompt version、実行日を記録します。評価は全体一致率だけでなく、選択率の差、順位一致、自由回答themeのprecisionとrecall、segment別error、再実行分散を並べます。指標は利用目的に合わせ、後から都合の良いものだけ選びません。
許容範囲は結果を見る前に決めます。たとえば仮説発散なら重要な反対理由を取りこぼさないこと、concept順位の補助なら上位候補の方向が安定することを重視します。価格や需要量では小さな誤差が意思決定を変えるため、合成回答の単独利用を禁止します。errorが許容範囲を超えたら、人間調査を増やすか用途を探索へ戻します。
profile情報を増やすとholdout性能が上がる場合でも、個人情報の取得と再識別riskが増えます。利用目的、同意、保存、access、削除を決め、不要な詳細を追加しません。合成personaを実在個人の忠実な複製と呼ばず、予測modelであることを利用者へ説明します。
市場やproductが変われば較正は古くなります。新しいsegment、価格改定、競合参入、model変更、prompt変更のいずれかが起きたら再検証します。成功した過去taskを根拠に別categoryへ横展開せず、用途ごとの再確認期限とownerを持ちます。
一次情報と確認範囲
確認日:2026年9月21日。海外の制度・製品仕様・研究結果は日本へそのまま適用せず、国内法・契約・対象条件を別途確認してください。