
「買いたい」65%を購入確率65%と読まない
仮の例として、生活者デジタルツインの65%が新商品を「買いたい」と答えても、購入確率65%とは読めません。回答時には魅力的に見えた商品でも、実際の売り場では価格、在庫、競合商品、家に残っている在庫、購入の手間が加わります。文章上の購入意向と、現金や時間を伴う選択は、別の観測です。
購入意向と販売の関係を扱ったメタ分析でも、予測力は調査や製品の条件によって変わると報告されています[1]。この研究は生成AI以前のものですが、「買うつもり」をそのまま販売数へ変換できないという問題は、合成人物にも当てはまります。むしろ大規模言語モデルは、筋の通った理由をすぐ生成するため、意向と行動の距離を見落としやすくします。
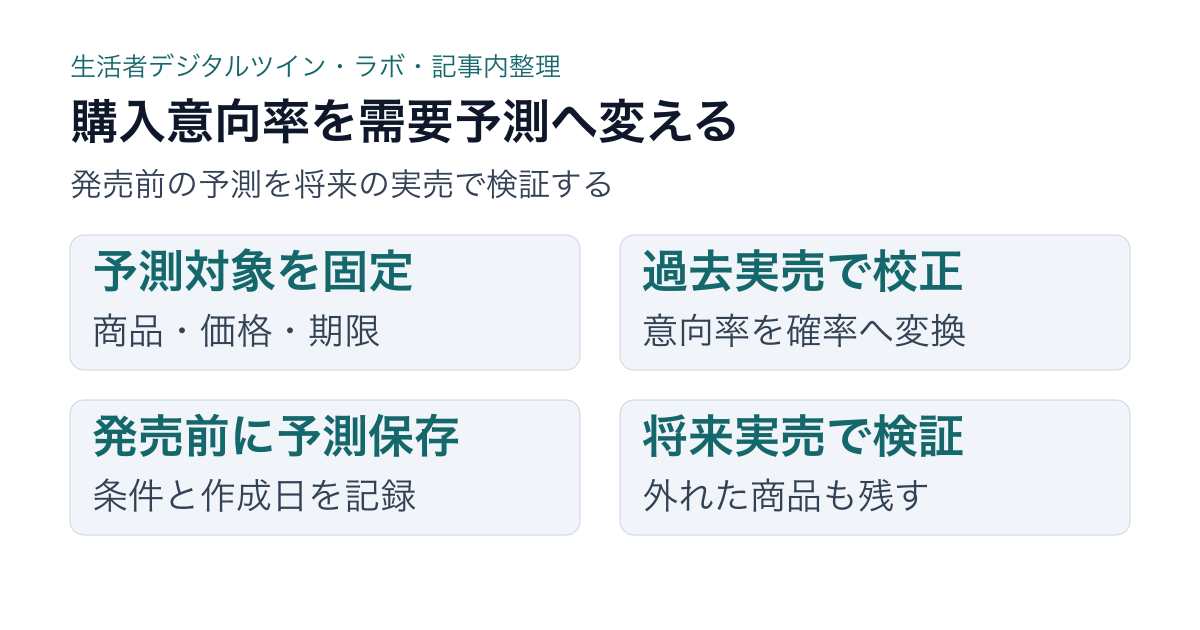
予測対象を商品・価格・販路・期限まで固定する
答え合わせの前に「誰が、どの商品を、いくらで、どの販路から、いつまでに一回以上買うか」を一文にします。分母も、全人口、広告到達者、既存顧客、来店者では違います。売上金額を予測するなら、購入者数、購入点数、単価をすべて予測対象に含めます。この一文を欠いた「購入意向率」は、後から都合のよい実績へ結びつけられてしまいます。
証拠は発言、選択、行動の三段に分けます。「魅力を感じる」は発言、同条件の候補から一つを選ぶのは選択、購入・継続・解約は行動です。上の段階で一致しても、下の段階まで当たったとは言えません。
MITの研究は、実在する人1,200人、その人の情報に基づくシミュレーション1,200体、完全な合成人物1,200体を比べました。環境配慮行動を促すチャットボットに対し、合成・シミュレーション参加者は態度を大きく変えた一方、人の態度はほとんど変わらず、シミュレーションは効果を過大評価しました[2]。一つのテーマと介入に限る結果ですが、自然な反応文が実際の変化量を保証しない反例です。
過去の実売で校正し、未来の商品を検証へ残す
まず、価格帯と販路が近い過去商品について、合成した購入意向率と実際の購入率を並べます。意向が高いほど購入も増えるか、何ポイント分を割り引くと実売に近づくかを確かめます。この対応づけが校正です。ただし、校正へ使った商品で精度を判定すると、既知の結果に合わせただけでも合格します。発売時期か商品群を分け、調整へ使わなかった将来期間を検証用に残します。
2026年に三つの食品選択実験を再現した研究では、大規模言語モデルが主要属性の影響方向を多くの場面で捉えました。一方、選択は人より決定的で、確率を合わせるには0.3〜0.4程度の縮尺調整が必要でした。感覚や文化に結びつく属性の誤差も大きく、人物情報を加えても一貫した改善はありませんでした[3]。初期の選択肢設計には使えても、生の回答比率を需要確率にはできない結果です。
同じ刺激と選択肢で属性効果の方向が合うことと、購入率の絶対値が合うことも分けます。企画の初期選別では順位一致が役立ちますが、在庫や売上計画には確率の校正が要ります。
順位と確率は別の合格条件を置く
会話型推薦を対象にしたACLの研究は、合成利用者の評価を、話題にする商品、二択の好み、自由な好み、推薦の求め方、推薦後の反応という五つへ分けました。その結果、モデルや指示の選び方で人とのずれが変わることを示しています[4]。一つの総合点では、どの行動を模倣できていないかが分かりません。
商品検証でも、自由回答のテーマ一致、候補の順位、意向率、購入率、販売数量を別々に記録します。候補AをBより上に置けても、Aの購入率を当てられるとは限りません。順位の合格は候補削減へ、確率の合格は販売計画へと、使い道を分けます。
CoeSignal(株式会社TechWorkerが提供するAIインタビュープラットフォーム)で購入意向の理由を詳しく聞く場合、得られるのは発言の証拠です。需要予測へ進めるなら、同じ対象条件の選択結果と販売記録を別に接続します。
予測を発売前に凍結し、実売後に答え合わせする
需要予測カードには、対象者、商品、価格、販路、購入期限、意向率から購入率への校正式、予測値、作成日を残します。発売後に条件を書き換えないよう、予測は発売前に凍結します。答え合わせでは、購入者数、購入点数、売上のうち、事前に選んだ指標だけを使います。予測から外れた商品も削除せず、価格、欠品、販促、競合投入などの差を記録します。
NIQは合成回答を初期のコンセプト選別へ位置づけ、実在消費者の回答で検証し、取引・パネルデータから把握した「現在実際に買っているもの」を入力へ使うと説明しています[5]。これは海外事業者の方法説明であり、公開ページだけでは製品ごとの予測精度を独立に確認できません。それでも、意向データだけで閉じず、行動データへ接続する設計は参考になります。
実務では、候補を広げる段階、選択肢を減らす段階、発売可否を決める段階で根拠を変えます。合成人物だけで行うのは仮説発散と調査票の事前点検まで。候補の順位づけには人の選択実験を残し、需要量は将来期間の販売記録で確かめます。値引きや広告の「効果」を知りたい場合は、予測の答え合わせだけで因果を決めず、条件を割り付けた実地テストを別に行います。
行動するAIの研究を、人の需要予測と混同しない
MITのABxLabは、買い物環境で動くAIエージェントの選択が、価格、評価、心理的な誘導によって大きく変わることを示しました[6]。これは、AIが選択行動を生成できる証拠です。ただし研究対象は、利用者に代わって購入するAIエージェントです。人の代理として答える生活者デジタルツインの精度を測った研究ではありません。AIの行動らしさを、人の行動再現性と読み替えてはいけません。
結論は用途ごとに残します。「自由回答の論点抽出には使える」「候補順位は人実査と照合する」「販売数量は校正と将来検証を通るまで使わない」と書き分けます。モデルや指示文を変えたら再検証し、過去に合ったという理由だけで未来の合格を出しません。予測の合否は、発売前に固定した数字と実売の答え合わせで決めます。自然な回答文は採否根拠にしません。
根拠資料
資料確認日:2026年9月27日。本文中の手順例は編集部の提案で、導入効果の実測値ではありません。
- When do purchase intentions predict sales?
- From Synthetic to Human: The Gap Between AI-Predicted and Actual Pro-Environmental Behavior Change After Chatbot Persuasion
- Do large language models shop like people? Comparing GPT and human food choices using discrete choice experiments
- Evaluating Large Language Models as Generative User Simulators for Conversational Recommendation
- The rise of synthetic respondents in market research
- A Framework for Studying AI Agent Behavior: Evidence from Consumer Choice Experiments