
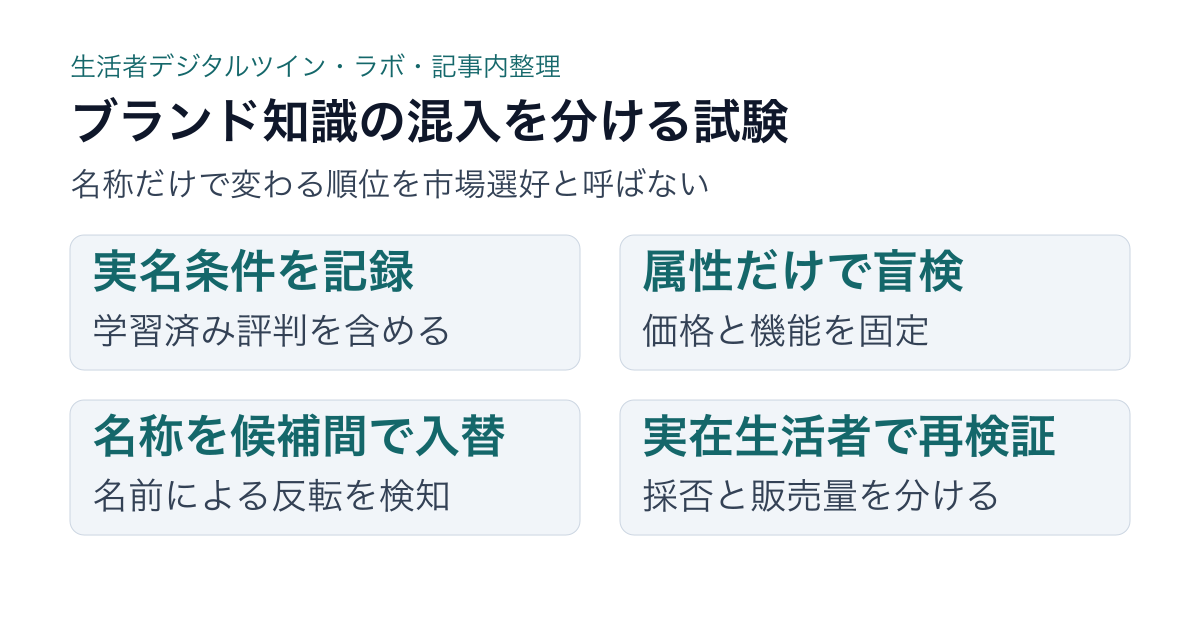
ブランド名を見せた結果だけで、新商品の負けを決めない
生活者デジタルツインが大手ブランドを選び、無名の新商品を避けても、生活者の反応を再現したとは限りません。モデルが事前学習で得た露出量、評判、国別イメージを答えている可能性があります。新旧ブランドを比べるときは、名前を見せた条件と隠した条件を分け、商品属性が同じなら選択がどれだけ動くかを先に測ります。
自然言語処理の国際会議EMNLP 2024で発表された研究は、靴、衣料、飲料、電子機器のブランドを使い、複数の大規模言語モデルがグローバルブランドを肯定的な属性へ結びつけやすい傾向を報告しました。利用者の国を示すと地域ブランドの選好が強まる原産国効果も見つかりました[1]。これは購買率の再現実験ではありません。それでも、ブランド名そのものが回答条件になる証拠です。
商品属性と学習済みイメージを別々に測る
検証用の商品カードを四組作ります。第一は実名、第二はブランド名を消した属性だけ、第三は同じ属性へ架空名を付けたもの、第四は競合間で名称だけを入れ替えたものです。価格、容量、機能、販路、保証などは固定します。順番も無作為に変え、同じモデル・指示文で複数回実行します。
古い世代の文脈言語モデルを調べた研究でも、モデル内部にブランドと「革新的」「信頼できる」といった属性の関連が表れることが確認されました。著者らは、この関連が推薦や感情分析へ影響し得ると述べています[2]。現在の生活者デジタルツインを直接評価した研究ではありませんが、名前を中立なラベルとして扱えない理由になります。
名称盲検では、選択率と理由を一緒に比較します。実名条件だけで「定番」「安心」「みんなが使う」が増え、属性だけの条件では消えるなら、その差を商品の魅力と混ぜません。逆に、名前を隠しても価格や機能の評価順が保たれるなら、少なくともその選択課題では属性の影響が残っています。
人気の説明文も入力条件として固定する
ブランド名を消しても、「販売数一位」「専門家推奨」「多くの人が選択」といった表現が人気の代理になります。EMNLP 2025の研究では、商品説明へ社会的証明を加えると、複数のLLMで推薦率や順位が一貫して上がりました。一方、希少性や限定性は可視性を下げる場合もあり、反応は単純ではありませんでした[3]。
比較試験では、レビュー件数、受賞、利用者数、権威づけの文を一度に変えません。元の説明、人気情報なし、同じ人気情報を全候補へ付与、候補間で入替、という条件を分けます。生活者も社会的証明へ反応しますが、モデルの反応量が人と同じとは限りません。ツイン内の差を市場効果と呼ばず、人の実査で検証する仮説として残します。
「LLMは必ず大手を選ぶ」とも決めつけない
人気偏りの反証もあります。Amazonの研究者らが映画の候補を順位順に指定件数まで示す推薦実験では、単純なLLM推薦は従来の推薦手法より人気偏りが小さく、明示的にニッチ作品を求める指示でさらに偏りを下げられました。ただし、推薦精度との交換条件がありました[4]。映画課題の結果なので、食品や日用品のブランド選択へ直接は移せません。
この反証が示すのは、偏りの方向を前提にしないことです。「大手優位になるはず」という先入観を置かず、カテゴリ、国、モデル、指示文、候補集合ごとに実名と盲検の差を測ります。偏りが出なかった試験も残し、都合のよいカテゴリだけを報告しません。
人に似た順位と、人と同じ選択確率を分ける
2026年の食品選択研究では、GPTが三つの選択実験で主要属性の影響方向を多く再現しました。ただし回答は人より決定的で、文化や感覚に結びつく属性の誤差が大きく、人物設定を加えても一貫して改善しませんでした[5]。大手と新興の順位が人と同じでも、選択率や理由まで一致した証拠にはなりません。
そこで合格条件を三つに分けます。属性効果の向きが人と合うか、実名と盲検の差が人の差に近いか、再実行して順位と理由が保たれるかです。一つでも外れたら、ツインは仮説を広げる用途に限定します。発売可否、市場シェア、販売数量には使いません。
提供者には学習データとブランド盲検の結果を聞く
NIQは合成回答を初期コンセプトの選別へ位置づけ、カテゴリごとに実在消費者の回答や購買行動で校正すると説明しています[6]。Qualtricsも、学習データの種類、現実の基準との比較、方法を監査できるかを確認項目として挙げています[7]。どちらも海外の提供者自身による説明で、公開情報だけでは自社カテゴリの精度を保証しません。
導入時には、一般のインターネット文章だけか、調査回答・購買データを使うか、国とカテゴリ別に検証したか、実名と架空名を入れ替えたかを聞きます。回答が得られなくても、自社で名称盲検はできます。結果表にはモデル名、実行日、指示文、候補順、ブランド表示条件を残します。
結論は「実名条件ではA、盲検ではB、名称入替で差が反転した」と条件つきで書きます。名称だけで順位が変わるなら、モデルが知っていたブランド像の影響を疑います。新商品の採否は、ブランド名のない属性評価、実在生活者の選択、発売後の行動を別々に確かめて決めます。
根拠資料
資料確認日:2026年9月28日。本文中の手順例は編集部の提案で、導入効果の実測値ではありません。
- “Global is Good, Local is Bad?”: Understanding Brand Bias in LLMs
- What BERTs and GPTs know about your brand? Probing contextual language models for affect associations
- Bias Beware: The Impact of Cognitive Biases on LLM-Driven Product Recommendations
- Large Language Models as Recommender Systems: A Study of Popularity Bias
- Do large language models shop like people? Comparing GPT and human food choices using discrete choice experiments
- The rise of synthetic respondents in market research
- Synthetic data for market research: Your questions, answered