
先頭の案が勝っても、企画案の勝利とは限らない
生活者デジタルツインへ複数の商品案や訴求案を選ばせるとき、選択肢の位置を固定してはいけません。同じ内容でも、先頭、末尾、A・B・Cのラベルによって回答が動くからです。候補Aを一番上に置いた結果だけで「Aが最も支持された」と結論づけると、内容の差と表示順の癖を混同します。
2026年の自然言語処理分野の国際会議で発表された研究は、世界価値観調査(World Values Survey)の設問を使い、18モデルへ10種類の変化を加えて33万4800件を超える模擬回答を比較しました。ほぼすべてのモデルが最後に示された選択肢を選びやすく、言い換えと複数の変化を組み合わせた場合にも回答が揺れました[1]。社会意識調査の結果なので、商品の購入選択率へそのまま移せません。それでも、位置を固定した合成回答を内容評価とみなせない根拠になります。
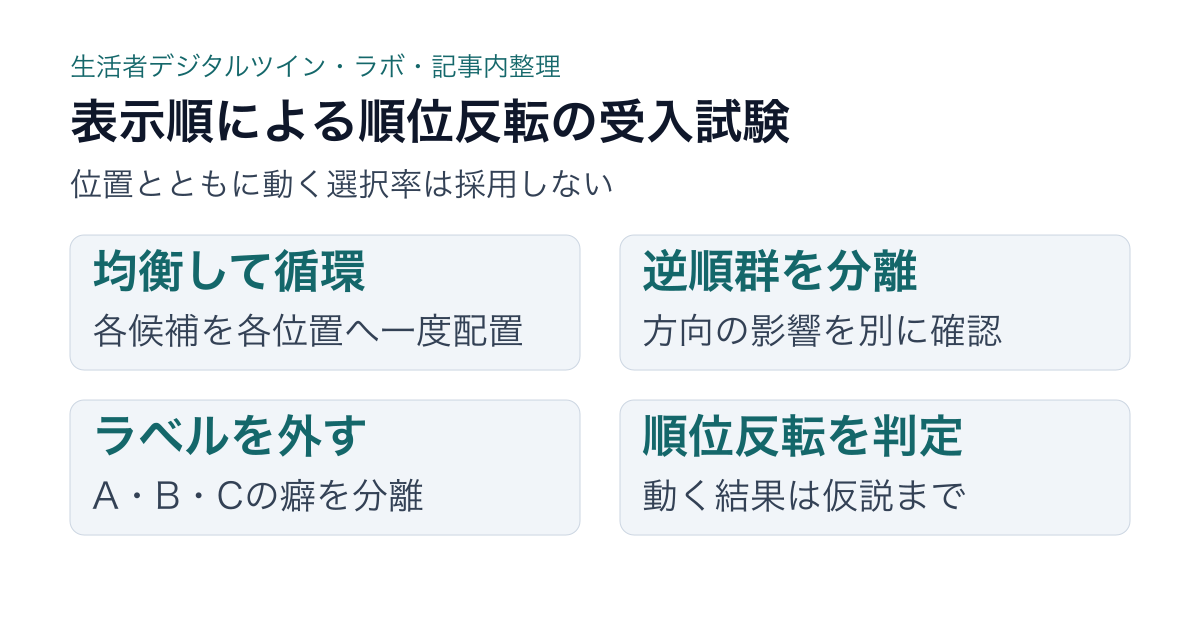
均衡した循環配置と逆順群を、同じ条件で回す
三つの案を比べるなら、まずA・B・C、B・C・A、C・A・Bの循環配置を使い、各候補が各位置へ一度ずつ出るようにします。方向の影響を見る逆順群はC・B・A、A・C・B、B・A・Cとして分けます。候補名の前に付けたA・B・Cも入れ替え、別の条件ではラベル自体を外します。価格、説明文、画像の代替テキスト、人物設定、モデル、生成設定は固定します。変えるのは順序とラベルだけです。
機械学習分野の国際会議NeurIPS 2024の研究は、米国国勢調査局の設問を使って43の言語モデルを調べました。回答は順序だけでなく、「A」と付けられた選択肢にも偏りました。ところが順序を無作為化して補正すると、今度はモデル回答が一様な乱数に近づく傾向も出ました[2]。無作為化は万能な修正ではありません。偏りが隠れたのか、内容を区別できていないのかを人の参照データで確かめる必要があります。
実行結果には、候補ID、表示位置、表示ラベル、選択、理由、再実行番号を残します。「Aが四割」だけでは監査できません。たとえば仮定上、同じAが先頭で六割、末尾で二割なら、平均四割を市場の選好として報告しないでください。ここでの数値は手順を示す例で、実測値ではありません。
順位より先に、位置を動かしたときの反転を見る
判定表では、各候補の平均選択率より順位反転を先に確認します。一回の実行で勝者が入れ替わっても、直ちに不合格とはしません。同じ配置を反復し、候補AとBの位置に応じた反転が繰り返されるかを見ます。反転が再現する、または差が一貫して大きく縮むなら、強い結論を避けます。理由文に「上記」「最初」「最後」など位置を示す語が増える場合も、内容以外の手がかりを使った疑いがあります。
同意度などを段階で答えるリッカート尺度の信頼性を調べた2026年の研究は、1235問それぞれに五つの言い換えと六つの位置配置を作り、八つのモデルを評価しました。基盤モデルでは先頭偏重、ラベル感度、極性の反転が起き、instruction tuning(指示追従の調整)で変動はおよそ半減しました。一方、ラベルを外したほうが一貫性が上がる条件もありました[3]。補正を一律に決めず、採用モデルと実際の設問で試験します。
人と同じ偏りを再現しても、生活者を再現した証明にはならない
人の紙面調査にも先頭を選びやすい傾向があります。大規模言語モデル(LLM)が似た順序効果を示しても、それだけで人らしいとは言えません。位置への反応量、質問内容との関係、属性別の差が人と一致する必要があるからです。自然言語処理の学術誌TACLに掲載された2024年の研究も、LLMへ人の調査で知られる複数の回答バイアスを与え、モデルごとに異なる反応を確認しました[4]。
反証もあります。順序を入れ替えればすべての偏りが消えるわけではありません。性格を5因子で測るBig Five性格検査を複数モデルで行った研究では、社会的に望ましい方向へ答える偏りが、質問順序の無作為化や言い換えの後も残りました[5]。したがって、順序入替に合格しても、社会的望ましさ、ブランド知識、質問文の誘導、人物設定の過剰な決めつけは別に検証します。
製品の無作為化機能と、妥当性検証を混同しない
QualtricsのSynthetic Panelsは、多肢選択と選択肢・質問の無作為化を対応機能に挙げています。ただし公開仕様では、利用可能な合成人口は米国一般人口の英語回答に限られます[6]。日本の顧客を想定した生活者デジタルツインへ、そのまま精度を移せません。
通常のQualtrics調査には、選択肢を無作為化する、逆順にする、一部を固定する、実際の表示順をデータへ出力する機能があります[7]。海外製品の実装から学ぶべき点は、各回答が見た順序を後から追えることです。生活者デジタルツインでも、順序を再現できない結果は比較対象から外します。
順序で動く結果は、仮説候補までに留める
合格条件は、すべての順序で一位が同じ、という一項目だけでは足りません。順位が保たれること、選択率の差が許容範囲に収まること、理由が商品属性へ結びつくこと、人の小規模実査でも方向が一致することを分けて判定します。許容範囲は企画判断の前に定め、結果を見て広げません。
限界として、入替試験は順序バイアスの検出には使えても、市場シェアや購入数量を証明しません。候補が似すぎていれば、人も順序に影響されます。反対に、圧倒的な差がある候補では順序効果が見えにくくなります。この試験は、ツインの順位を企画会議へ持ち込めるかを決める受入検査です。
候補を三つ用意し、順序とラベルだけを変えた結果表を一枚作ってください。勝者が位置とともに動くなら、その選択率は採用しません。順序を変えても結論が残った部分だけを、人の調査で確かめる仮説として次へ渡します。
根拠資料
資料確認日:2026年9月29日。本文中の手順例は編集部の提案で、導入効果の実測値ではありません。
- Prompt Perturbations Reveal Human-Like Biases in Large Language Model Survey Responses
- Questioning the Survey Responses of Large Language Models
- Do LLMs Give Consistent Opinions?
- Do LLMs Exhibit Human-like Response Biases?
- Large language models display human-like social desirability biases in Big Five personality surveys
- Synthetic Panels - Qualtrics
- Choice Randomization - Qualtrics