
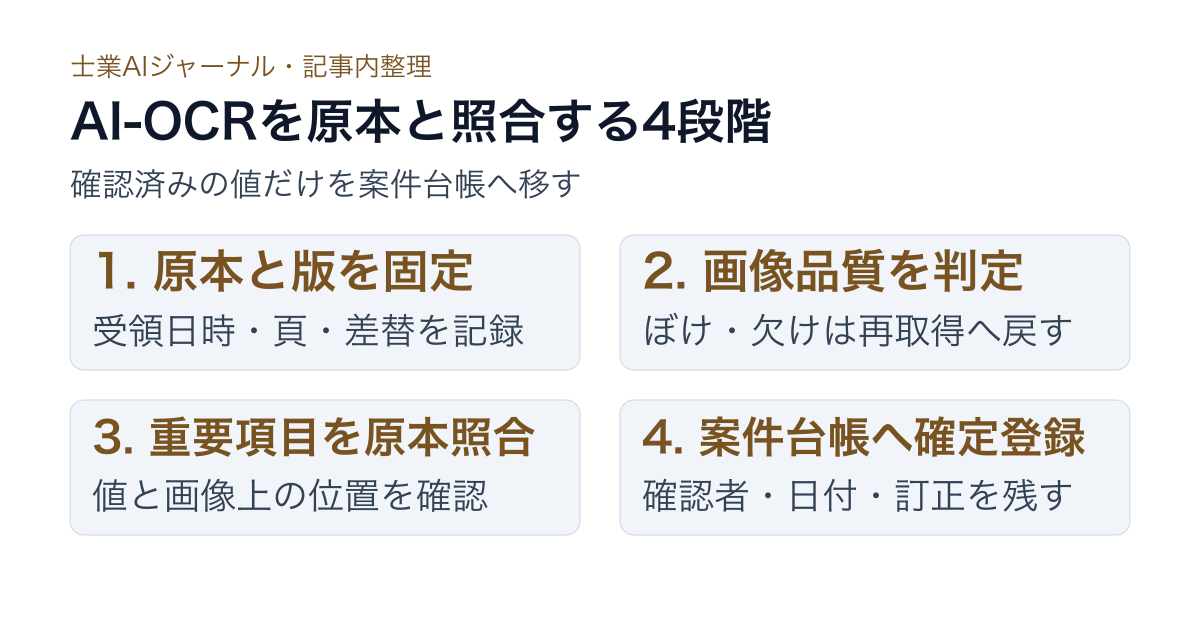
申請書、請求書、本人確認書類、手書きの相談票をAI-OCRへ通すと、転記の初動は速くなる。だが、抽出結果をそのまま案件台帳へ登録すると、日付の一桁、金額の桁、氏名の異体字、チェック欄の読み違いが専門判断の前提へ入る。士業事務所でAI-OCRへ任せるのは候補抽出までであり、正本の確定ではない。
確認工程は「画像品質」「文字抽出」「項目対応」「案件上の採否」を分ける。信頼度の数値は、人が見る箇所を絞る材料にはなるが、正しさの証明ではない。原本の画像と抽出箇所を並べ、重要項目は値と位置を確認してから案件台帳へ移す。
受付時に原本と用途を固定する
最初に、紙原本、顧客が送ったPDF、撮影画像のうち、OCR結果を照合する業務上の参照元を定める。法令・提出先・契約上の原本性は任意に決めず、書類種別ごとに別途確認する。ファイル名だけでなく、受領日時、ページ数、表裏、差替版、案件IDを記録する。OCR後のテキストを参照元へ置き換えない。後から値が争われたときに、どの画像のどの位置を読んだかへ戻れなければならない。
低品質の画像は文字抽出の前に除外し、再取得へ戻す。Google Document AIは、一般に200dpi以上、300dpi以上で良い結果が得られやすいと案内し、解像度、文字サイズ、手書き品質などで精度が変わるため試験を勧める[1]。同サービスは、ぼけ、暗さ、文字の小ささ、欠け、反射などをページ単位の品質情報として返せる[2]。低品質の画像をモデル設定だけで補おうとせず、再撮影・再読取りへ戻す。
信頼度を自動承認の印にしない
抽出結果には、氏名、住所、日付、金額、識別番号、選択欄ごとに原本位置と確信度スコア(抽出結果へのモデルの自己評価)を持たせる。Microsoft Document Intelligenceは、単語、項目と値、選択欄などへ0から1の確信度を返し、重要な用途では人の確認へ回す設計を案内している[3]。一方、人には似て見える文書でも、モデルには学習時の文書と異なる形式に見える場合があると注意する。
一律に「0.9以上なら正しい」と決めない。Microsoftの透明性資料は、実際の用途を代表する試行で信頼度と抽出品質の範囲を確かめ、その結果から自動処理と人手確認の閾値を決めるよう求める[4]。氏名の一文字、期限、金額、法人番号のように誤りの影響が大きい項目は、信頼度が高くても原本照合を必須にする。
確認画面では、抽出文字だけでなく原本の該当範囲を横に表示する。Microsoftは、抽出値と原文位置を対応付け、確信度が低い結果を人の確認へ送る考え方を示す[5]。ただし同資料は、学習用の正解ラベルを足しても、文字のlを数字の1と読むような文字認識そのものの誤りが直るとは限らないと明記する。項目抽出と文字認識を別に点検する理由である。
業務ルールはOCRの後に適用する
OCRが「2026年10月1日」「100,000円」と読めても、その日付が提出期限か契約日か、その金額が税込みか合計かは確定しない。項目名、周辺文、頁、文書種別を見て対応を決める。案件台帳には、抽出値、原本位置、確認者、確認日、状態を残し、状態を「未確認」「原本一致」「訂正」「判断保留」に分ける。
二重確認は全項目へ均等に置かない。提出期限、顧客識別、振込額、権利義務に関わる選択欄は二人目の確認へ回す。住所の空白や全角半角など、意味を変えない整形は規則で処理できる。例外台帳には、手書き、訂正印、欄外追記、複数ページにまたがる表、画像の欠け、同じ名称の複数項目を集め、次の受入試験へ戻す。
保存要件と読取精度を混同しない
OCRで検索できるようにしただけでは、法令・提出先・契約上の保存要件を満たしたとは限らない。国税庁の電子帳簿保存法一問一答は、国税関係書類のスキャナ保存について、真実性、可視性、帳簿との相互関連性などの要件を示す[6]。この制度は全ての士業書類へ一律に適用されるわけではないが、「文字を読めた」と「法令・契約上の保存を満たした」を分ける必要性は共通する。
海外製品の信頼度や人手確認の説明も、日本の士業の確認責任を代替しない。Amazon Textractのサービス資料は、高リスクまたは慎重な取扱いを要する用途では、適切に人手確認を組み込むよう案内している[7]。日本での提出要件、原本還付、保存期間、本人確認、各士業の職業規程は、案件と提出先ごとに有資格者が確認する。
導入前には、実際に届く文書から、鮮明なスキャン画像だけでなく、斜め撮影、薄い印字、手書き、訂正、表裏、欄外追記を含む検証集合を作る。合格判定では平均文字正解率だけでなく、期限・金額・氏名・選択欄の誤登録件数と、参照元へ戻れない抽出件数を測る。AI-OCRの完了条件は、全項目を自動登録できることではない。誤りや迷いを参照元の位置とともに人へ返し、確認済みの値だけが案件台帳へ入ることである。
根拠資料
資料確認日:2026年9月29日。本文中の手順例は編集部の提案で、導入効果の実測値ではありません。
- Google Cloud, Document AI Supported Files
- Google Cloud, Enterprise Document OCR
- Microsoft Learn, Accuracy and confidence scores
- Microsoft Learn, Transparency note for Document Intelligence
- Microsoft Learn, Confidence, grounding, and labeled samples
- 国税庁, 電子帳簿保存法一問一答(スキャナ保存関係)
- AWS, AI Service Card: Amazon Textract AnalyzeID