過去の申請書、相談記録、通知文、所内の手引きを生成AIで検索できれば、担当者が「前回どの根拠で処理したか」を探す時間は減らせます。ただし、検索結果に出典が表示されることと、その文書を今回の担当者・案件で見せてよいことは別です。顧問先や案件をまたぐナレッジ検索で先に決めるべきなのは、モデルの賢さではなく、どの文書集合を、誰が、どの案件のために検索できるかです。
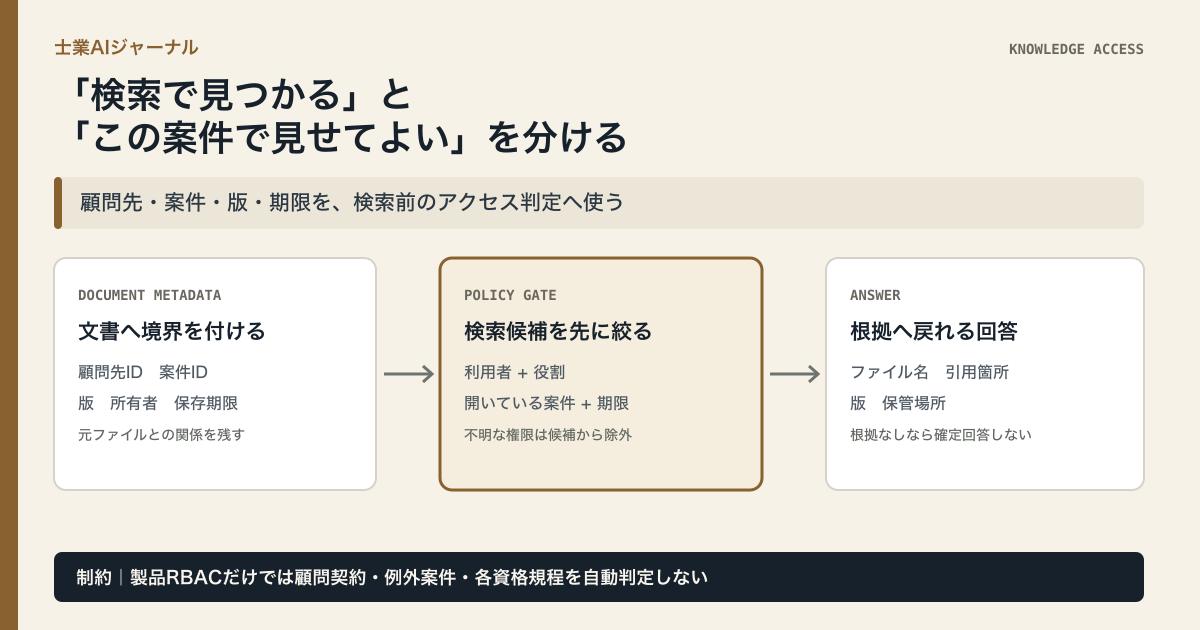
結論は、文書を一つの大きな「所内AI知識庫」に入れないことです。最低限、顧問先、案件、文書種別、担当部署、保存状態、参照期限を持たせ、検索時にはログインした人と開いている案件に合う文書だけを候補にします。回答には根拠ファイル名・版・保管場所を表示し、引用元を開けない人には要約も返さないようにします。AIが過去の資料を見つけられることを、横断利用の許可と取り違えない設計です。
先に「検索対象」を三つに分ける
最初の棚卸しでは、ファイルを機密度だけでなく、利用目的で分けます。第一は所内共通で使える手続き手引き、法令原典へのリンク、公開済みの様式説明です。第二は顧問先ごとに閉じる契約、申請控え、相談記録、個人情報を含む資料です。第三は担当交代、利益相反、契約終了、係争、保存期限などにより、通常の案件担当者にも開かない例外資料です。
二番目と三番目を「検索で見つかったから」と横断表示してはいけません。個人情報保護委員会は、生成AIに個人データ等を入力し、提供者が学習に用いる場合には提供に当たり得ること、利用目的の範囲内で適正に取り扱う必要があると注意喚起しています。また、個人情報保護法のQ&Aは、プロファイリングのような分析では分析処理自体を含め、本人が合理的に想定できる程度に利用目的を特定する考え方を示しています。顧問契約、職業上の守秘、個人情報保護法、各士業の規程は適用関係が一律ではありません。導入前に、扱う資格・業務・契約ごとに確認してください。
アクセス判定を「格納・検索・回答」に分ける
実装は、次の三層にするとレビューしやすくなります。
- 格納時:文書ごとに顧問先ID、案件ID、文書の版、所有者、保存期限、持出し可否を付ける。OCRした本文だけを取り出して、元ファイルとの関係を失わない。
- 検索時:質問文だけでなく、利用者ID、役割、開いている案件ID、閲覧期限を検索条件として渡す。権限情報が不明な文書は候補から除く。
- 回答時:根拠文書と引用箇所を示す。根拠が一件もなければ「該当資料なし」と返し、一般知識で補って確定的な実務回答にしない。
この順番なら、回答の後から「なぜこの資料を見せたか」を追えます。逆に、フォルダをまとめて検索し、プロンプトで「他の顧問先の情報は出さないで」と頼むだけでは、権限管理を生成結果に委ねることになります。NISTの生成AIプロファイルは、生成AIのリスクが入力・出力・人との相互作用にまたがり、導入前テストとガバナンスを含む管理を扱っています。士業では、検索の品質評価と参照許可の評価を別のテストにしてください。
最初の実証は一顧問先・一用途に閉じる
初回は、契約が継続している一顧問先の、更新済み手引きと過去の確定書式だけに範囲を閉じます。担当者が十件程度の実際の質問を用意し、(a) 正しい資料を見つけるか、(b) 古い版を引用しないか、(c) 権限外資料がゼロ件か、(d) 根拠を開いて人が検証できるか、を個別に採点します。正答率が高くても(c)が一件でも起きたら、対象を広げず、文書の属性・連携元の権限・例外案件の除外規則を直します。
ベンダーの「企業データは既定で学習に使わない」「接続元の権限を尊重する」といった説明は、契約・設定の確認材料にはなります。たとえばOpenAIの法人向け説明でも、組織データを既定で学習に使わないこと、接続先の既存権限を尊重することを案内しています。しかし、これは自社の顧問先・案件区分を自動で設計する保証ではありません。複数ロールの権限が加算される製品もあるため、製品固有の権限評価と、文書側のアクセス設計を両方確認します。
海外の職業規範は日本の結論を代替しない
米国ABAのFormal Opinion 512は、弁護士が生成AIを使う際に能力、依頼者情報の保護、説明、監督等を考慮すべきだと述べています。これは米国の弁護士規範であり、日本の税理士、社労士、行政書士、司法書士、弁護士に直接適用されるルールではありません。一方で、「アクセスできる」と「案件のために使ってよい」を分ける発想は、所内検索の設計を点検する比較材料になります。日本では、個人情報保護法上の利用目的・委託等に加え、顧問契約と該当資格の規程を個別に確認する必要があります。
生成AI検索は、専門判断や原典確認を置き換えません。検索結果を入口にして、現行の法令・通達・契約・原資料へ戻れる状態を残すと、再利用の速さと案件の境界を両立できます。士業AIのナレッジアクセス設計を案件単位で整理したい方は、士業AIのナレッジアクセス設計を相談するをご利用ください。
情報図解の結論・3ステップ・制約
- 結論:所内ナレッジ検索は「見つかる文書」ではなく「今回の利用者・案件に見せてよい文書」を先に絞る。
- 3ステップ:①文書へ顧問先・案件・版・期限を付ける ②利用者・案件を検索条件にして候補を絞る ③根拠と版を表示し、人が原典を確認する。
- 制約:製品のデータ学習設定やRBAC(役割別権限)だけでは、顧問契約・案件例外・各資格の規程への適合を自動判定しない。職種・契約・個人情報の取扱いは個別確認が必要。
関連内部リンク
既存記事との差分・重複判定
既存記事は、ベンダー選定の契約・保存・一般的な権限、案件記録、外部操作の承認、研修、事故対応を扱う。本稿の検索意図は、過去案件・書式をRAG(検索拡張生成)等で横断検索したい士業事務所が、顧問先・案件別の検索候補と回答根拠をどう分離するかである。外部への送信・提出の承認設計(9月12日)や、ベンダー契約の比較(9月8日)ではなく、所内ナレッジの参照境界と版の管理に限定するため、意図は重複しない。
一次情報と確認範囲
確認日:2026年9月13日。製品仕様・制度は更新されるため、導入時はリンク先の最新版を再確認してください。海外の制度・職業規範は日本へ直接適用せず、相違点と限界を本文に明記しています。
- 生成AI提供者が入力を学習に使う場合、個人データ等の入力は提供に当たり得る。利用目的の範囲内で適正な取扱いが必要
- プロファイリング等では分析処理を含め、本人が合理的に想定できる程度に利用目的を特定する考え方が示されている
- AI利用者を含むリスクベースのガバナンスを扱う
- NISTの生成AIプロファイルは、ガバナンス、来歴、導入前テスト、インシデント開示を主要論点にする
- OpenAI法人向けは組織データを既定で学習に使わず、アクセス制御・監査等を案内する
- Company Knowledgeは接続元で既に許可された情報だけを取得すると説明する
- 米国ABAの生成AI意見書は、能力、依頼者情報保護、説明、監督等を考慮すべきとする
- ChatGPT Enterpriseの通常ロールは、複数ロールの許可を加算して評価する仕様がある