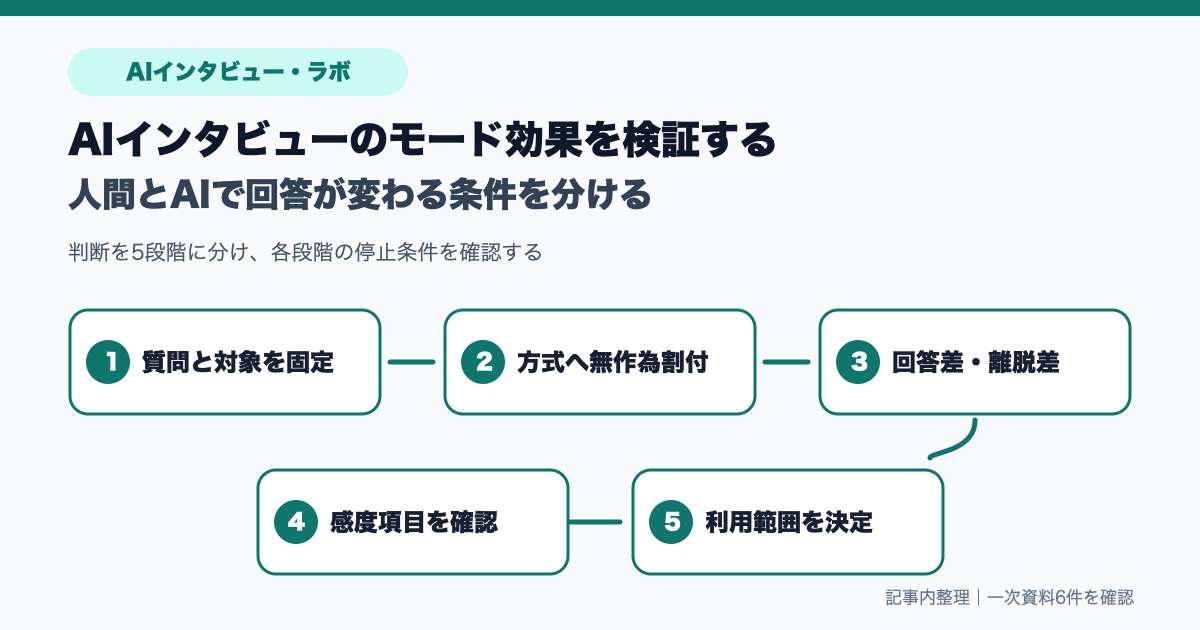
AIインタビューを人間の聞き手から置き換えたとき、同じ対象者へ同じ質問を出しても、回答の長さ、センシティブ情報の開示、途中離脱が変わる場合があります。重要なのは、AIの回答が「率直に見える」ことを品質と決めず、方式だけを変えた比較で、どの項目にどの方向の差が出るかを確かめることです。
方式を変えると回答も変わり得る
AAPORは、電話とウェブなど調査モードの変更が、実際の態度変化のように見えることがあると注意しています[1]。Pew Research Centerの無作為化比較では、電話とウェブで60項目中多くに数値差があり、差の中央値は5ポイントでした[2]。これはAIインタビューでも必ず同じ差が出るという意味ではありません。しかし、対人圧力、回答時間、質問の見え方が変われば、回答過程が変わるという検証仮説になります。
とくに健康、収入、職場の不満など社会的望ましさが働く項目は、AIの方が話しやすい可能性も、信頼できず話さない可能性もあります。方向を先に決めず、項目別に差を確認します。
比較前に対象者と質問を固定する
人間群とAI群の属性が違えば、方式差と対象者差を切り分けられません。同じ募集母集団から参加者を割り付け、質問文、提示順、回答時間、謝礼、端末条件を揃えます。実査途中でAIだけ追問を変えた場合は、変更後を別版として扱います。
CDCのCCQDERは、質問理解、想起、判断、回答選択の過程を認知インタビューで調べています[3]。本比較の前に少人数で「何を聞かれたと理解したか」を確認し、モード以前の質問不備を除きます。米国国勢調査局も、認知インタビューやsplit panel testを質問票の事前評価に位置づけています[4]。
回答内容と実査行動を分けて測る
比較指標は、テーマ出現数だけでは足りません。完了率、離脱位置、回答文字数、追問回数、回答までの時間、拒否、矛盾、原文へ戻れる根拠を記録します。内容面では、同じコード体系で独立に分類し、方式名を隠した状態で一部を二重判定します。
センシティブ項目では、開示量が多いことを自動的に良いとしません。不要な個人情報まで増えていないか、撤回やスキップが機能したかを併せて見ます。AAPORのbest practicesは、母集団、標本、質問全文、方式を開示することを求めています[1]。
差が出た項目だけを再検証する
一度の比較で「AIの方が優れる」と結論づけません。差が大きい項目を、質問負荷、社会的望ましさ、追問、UI、回答時間に分解します。Pewの研究でもモード差は項目によって異なり、すべてが同じ方向へ動いたわけではありません[2]。
再検証では、モデレーター方式だけを変え、対象者構成と質問版を固定します。結果は平均差だけでなく母数と不確実性を示します。CoeSignal(株式会社TechWorkerが提供するAIインタビュープラットフォーム)で実査する場合も、人間調査との比較条件と版を分けて保存します。
人間とAIの比較実査を相談する
運用へ残す最小記録
対象母集団、割付方法、質問版、方式、端末、実査期間、離脱、除外、分析コード、差が出た項目、再検証条件を一つの比較表へ残します。方式を混在させて集計するときは、取得方式を消さず、結論が方式に依存しないかを確認します。
実務では、全設問を毎回比較するのではなく、重要な意思決定へ使う設問、センシティブな設問、前回差が大きかった設問を監視対象にします。四半期ごと、またはAIモデル・画面・追問規則を変えたときに小規模な並行実査を行い、差の方向と大きさが許容範囲内かを再確認します。差が再現しなければ偶然や標本構成の影響も疑い、差が再現した場合だけ方式別の解釈ルールへ反映します。
適用限界
一つの業界、一つの質問票で得た差は、別の顧客群へそのまま一般化できません。AIモデルやUI更新でもモード条件は変わります。高影響の意思決定では、人間調査、AI調査、行動データを組み合わせ、AIだけで市場割合や因果を推定しません。
一次情報と確認範囲
確認日:2026年9月19日。製品仕様・制度・研究結果は更新されるため、導入時はリンク先の最新版を再確認してください。海外の制度・職業規範は日本へ直接適用せず、相違点と限界を本文に明記しています。