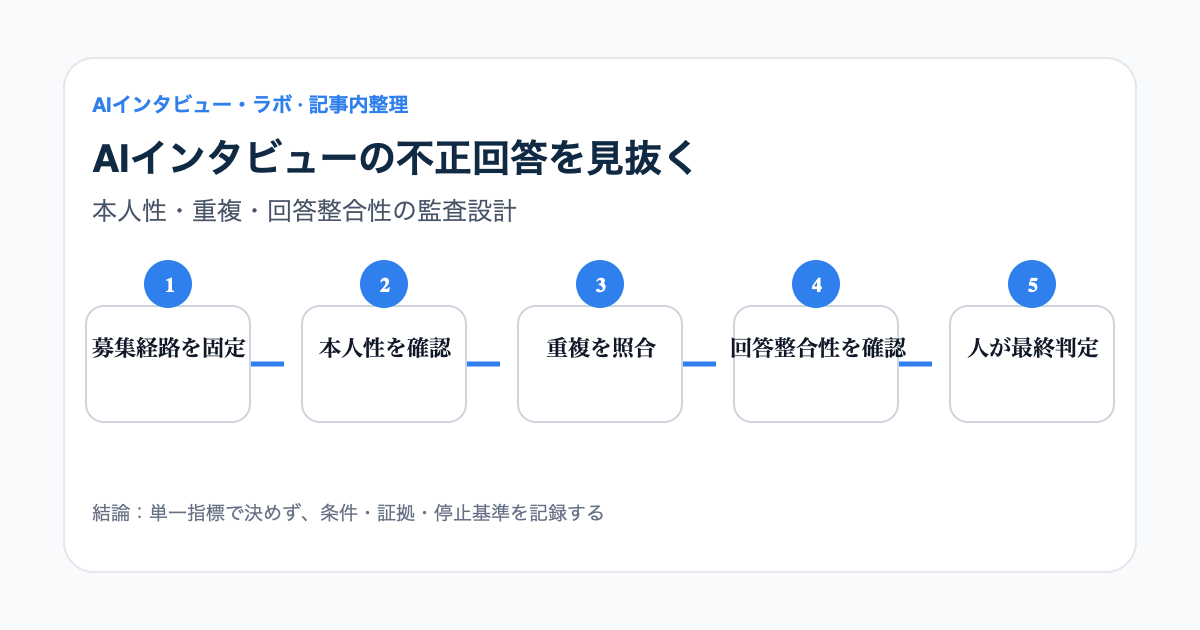
AIインタビューやオンライン調査で、bot・重複・報酬目的の不正回答を単一指標で誤判定せず、募集から除外記録まで多層で監査する方法を解説します。
不正回答はbotだけではない
オンライン調査の品質問題には、自動bot、同一人物の重複参加、属性の偽装、報酬だけを目的とした高速回答、人が生成AIで作ったもっともらしい自由回答が含まれます。Pew Research Centerは、opt-in sampleで不誠実な回答者が希少属性や行動の推定を大きく歪め得ると報告しています[1]。AIインタビューでも、文章が自然だから本人の経験だとは判定できません。まず募集経路、本人確認、端末・接続、回答内容を別の証拠として扱います。
募集前に一人一回の条件を決める
招待token、panel ID、回答期限、謝礼条件を実査前に固定します。公開URLを広く配る場合は、再利用できない招待、送付先との照合、過度に詳細な選別条件を募集文へ出さない運用が必要です。AAPORのonline sample報告は、speedingやattention checkだけでは不誠実回答の多くを見逃すと指摘しています[2]。一つの罠質問で合否を決めず、多層の信号を組み合わせます。
機械判定はフラグに留める
IP、device、cookie、所要時間、同文反復、矛盾、自由回答の類似度は有用ですが、VPN利用者、共有端末、支援技術の利用者まで誤って除外し得ます。研究では複数の自動検知と人の再確認を組み合わせた運用が比較されています[3]。機械判定は除外の自動執行ではなく、review対象を絞るフラグとして使い、根拠を残します。
回答の整合性は経験の具体性で見る
自然な長文より、時系列、固有の状況、行動、結果がつながるかを確認します。同じ事実を別の角度から尋ね、矛盾が出た場合は誘導せず再確認します。Pewの2020年研究では、重複、質問と無関係な自由回答、常に肯定する回答などを組み合わせてbogus dataを特定しました[4]。文章生成の上手さではなく、募集時の情報と回答過程を横断して見ます。
除外理由と感度分析を残す
各回答を採用、要確認、除外に分け、理由、判定者、判定日を保存します。除外前後で主要テーマがどう変わるかも比較します。少数segmentだけが消えるなら、品質改善ではなくcoverageの悪化かもしれません。CoeSignal(株式会社TechWorkerが提供するAIインタビュープラットフォーム)で実査する場合も、不正検知だけで結論を自動確定せず、元発話と募集記録へ戻れる状態を保ちます。
適用限界
本人確認を強くするほど参加負荷と個人情報リスクが上がります。海外panelの不正率を日本の顧客調査へそのまま当てはめず、調査目的と謝礼額に応じて必要最小限の確認にします。高影響な判断では、不正回答除外後も実顧客の行動データや追加面談で確かめます。
実査チームの判定手順
実査開始前に、重複、本人性、所要時間、回答整合性の各signalを定義し、単独で除外へ使わないことを判定表へ書きます。high risk、要review、問題なしの三段階にし、high riskでも元回答を削除せず隔離します。後から基準を変えた場合はversionと対象期間を残します。
一次reviewは募集記録と技術signal、二次reviewは発話内容を担当し、同じ担当者が自分の仮説に合う回答だけ残すことを避けます。自由回答は、文章の流暢さより、質問への関連、時間関係、利用場面、固有の制約、前後の矛盾を見ます。疑わしい場合は短い再確認を行い、個人情報を追加で取りすぎません。
品質報告には、総回答数、flag件数、review件数、除外件数、理由別内訳、除外前後の主要テーマ差を載せます。除外率だけをKPIにすると、厳しく落とすほど品質が高く見えるため、誤除外のsample reviewと、調査対象のcoverageが保たれたかを併記します。
検知規則は不正者に公開しすぎない一方、依頼者には判定手続きと限界を説明します。調査ごとに謝礼、募集経路、対象者の希少性が違うため、前回の閾値をそのまま再利用せずpilotで調整します。
一次情報と確認範囲
確認日:2026年9月21日。海外の制度・製品仕様・研究結果は日本へそのまま適用せず、国内法・契約・対象条件を別途確認してください。