本文
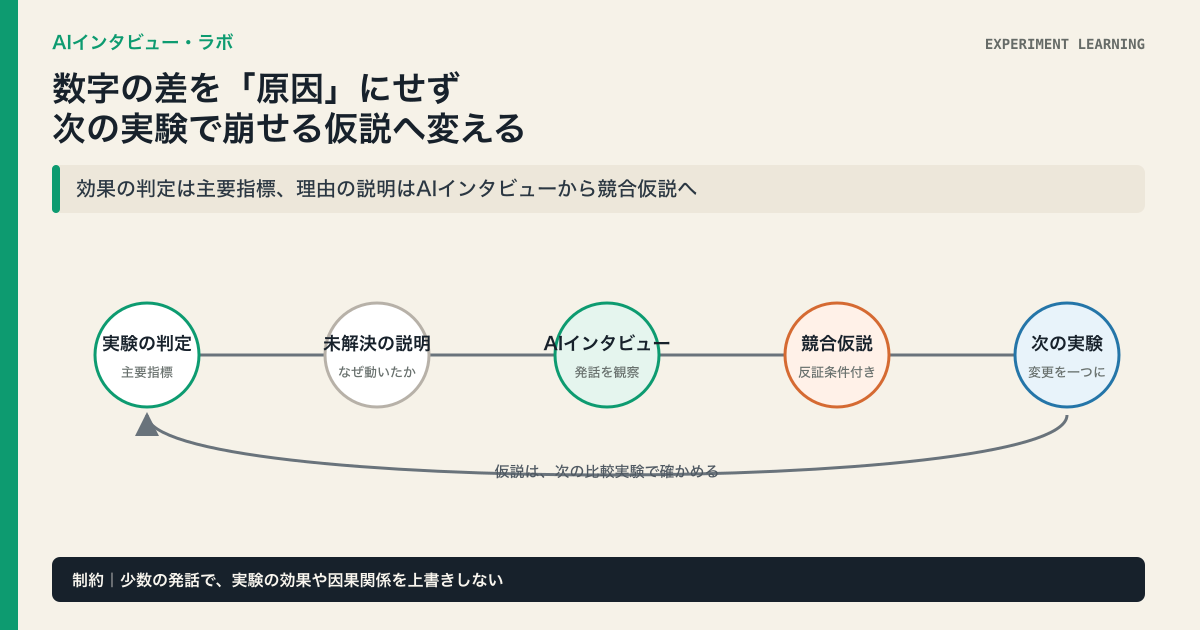
コンバージョン率や継続率に差が出ても、実験の数字だけでは「利用者が何を理解し、どこで迷い、何を比較したのか」までは分かりません。A/Bテストは変更の効果を比較するための手法であり、勝因を物語として断定する装置ではないからです。ここで必要になるのが、効果判定を崩さずに、次に検証すべき原因仮説を集める定性調査です。
その実査の選択肢が、CoeSignal(株式会社TechWorkerが提供するAIインタビュープラットフォーム)です。本稿では、A/Bテストを「どちらを採用するか」、AIインタビューを「なぜその結果になったと考えるか」という別の問いに置き、両方を一つの学習サイクルにする方法を扱います。
先に分けるべきは、効果の判定と理由の説明
Microsoft Researchは、無作為化された比較実験を機能変更が顧客行動へ与える影響を評価する方法として位置づけています[1]。一方で、実験結果から回答者の動機を一意に復元できるとは述べていません。たとえばB案の申込率が高くても、コピーが分かりやすかったのか、不安を減らしたのか、特定の利用状況だけで効いたのかは、計測値だけでは決まりません。
そこで、「B案を採用する」は事前に定めた主要指標とガードレールで判断し、「なぜB案が動いたのか」は別途、反証可能な仮説として扱います。英国政府のTest and Learnは、A/Bテストとインタビュー・観察などを組み合わせることで、単一手法では見落としうる意図しない影響を捉えられると整理しています[2]。これは定性調査で実験結果を上書きするという意味ではありません。定性の役割は、次の変更案と次の実験の質を上げることです。
実験の直後に聞く、四つの問い
対象者はA群・B群それぞれから、主要指標の結果だけでなく新規/既存、完了/離脱など、あらかじめ決めた比較軸で募集します。群をまたいで「どちらが好きか」と聞くのではなく、本人が実際に見た体験を起点にします。
- 理解:この画面・案内を見て、何ができると理解しましたか。
- 判断:続ける/やめる直前に、何を比較し、何が足りませんでしたか。
- 行動の文脈:その時に解決したかった仕事や困りごとは何でしたか。
- 反証:別の説明として考えられること、画面以外に影響したことはありますか。
聞き返しは発話の具体化と意味確認に留め、「B案のほうが良かったですよね」と結果を教える質問は避けます。実験の仮説、割付期間、対象、主要指標、観察した差をインタビュー設計書に渡し、インタビュアーには群名ではなく提示体験と質問の意図だけを見せると、結果への後付けを減らせます。AIモデレートで同じ核となる問いを保ちつつ、個々の発話に沿って深掘りできる点は、複数セグメントを短期間に比べる時に有用です。
「原因」と書かず、次の検証可能な仮説にする
分析表は、印象的な引用集ではなく、次の列を持たせます。
| 実験で確認した差 | 発話の観察 | 競合する説明 | 次に変える要素 | 次の判定指標 |
|---|---|---|---|---|
| B案で主要指標が改善 | 一部の参加者が手順を具体的に説明できた | 既存利用者に偏った可能性 | 手順表示だけを変える | 同じ主要指標と離脱率 |
この表で大切なのは、発話を「原因」と決めないことです。発話は仮説の根拠であり、次の実験の入力です。GOV.UKのA/Bテストガイドも、変更・予想する結果・その理由を明瞭な仮説として事前に文書化し、計測が正しいか品質確認するよう求めています[3]。AIインタビューの出力も、引用元、対象群、聞かれた質問、解釈者、反証を残せば、次の担当者が判断の経路を再確認できます。
使わないほうがよい場面もある
統計的な結論を急いで出すために、少数の語りを使うのは誤りです。セグメント間の差や影響量を決めたい時は、実験設計と十分な標本を優先します。また、画面上の行動を正確に再現する必要があるなら、インタビューだけで完結させず、同意のうえでタスク観察や画面記録を組み合わせるべきです。GOV.UKも、利用者調査とパフォーマンス指標を組み合わせ、失敗理由はクリック経路や記録から検討することを勧めています[4]。
AIを分析に使う場合はさらに、データセットの作成・分析・報告・解釈でAIを用いることを依頼者へ透明にし、既知・潜在的なバイアスを示すというICC/ESOMAR Code 2025の考え方が参考になります[5]。NIST AI RMFも、文脈を記録し、定性的・定量的な手法で評価して、文書化と継続的な見直しを行う枠組みを示しています[6]。
まずは「次の一手」が未決の実験を一つ選ぶ
実験の勝敗が決まった直後に、「この数字を見て、次に何を変えるかが決められない」案件を一つ選びます。主要指標、ガードレール、対象群、まだ競合している説明を一枚にまとめ、各説明を崩しうる問いを設計する。これなら、AIインタビューは結果を飾る後日談ではなく、次の実験の学習速度を上げる工程になります。
一次情報と確認範囲
確認日:2026年9月15日。製品仕様・制度は更新されるため、導入時はリンク先の最新版を再確認してください。海外の制度・職業規範は日本へ直接適用せず、相違点と限界を本文に明記しています。