本文
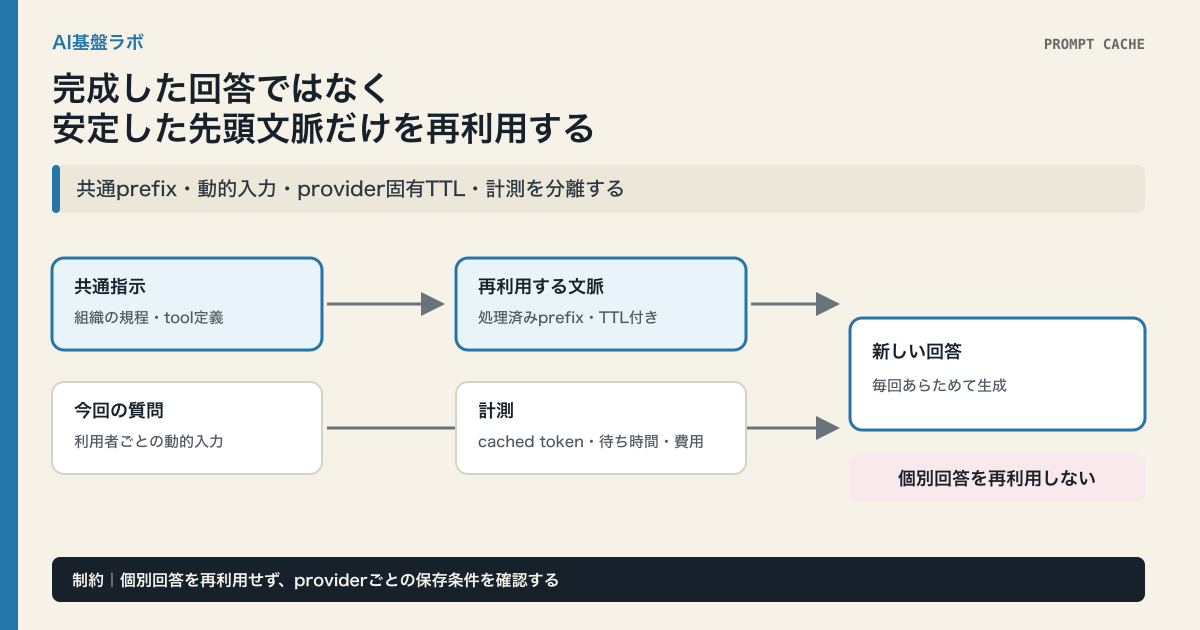
長いsystem instruction、tool定義、規程文書を毎回モデルへ渡すAIアプリでは、入力tokenの処理が遅延と費用を押し上げます。そこで使われるprompt cacheは、前回の応答を返すキャッシュではありません。同じ先頭文脈をモデルが処理した中間状態を再利用し、新しい質問に対しては毎回あらためて生成する仕組みです。
結論は、cacheを有効化することではなく、再利用できる安定prefix、利用者ごとに変わる動的入力、provider固有のTTLと計測を分離することです。これなら個別回答を取り違えずに、長い共通文脈の処理を減らせます。
応答cacheとprompt cacheは、守る対象が違う
AI Gatewayなどの応答cacheは、同じrequestに対する完成済みの回答を返します。Cloudflare AI Gatewayは既定でprovider、endpoint、model、認証情報、request body全体を使ってkeyを作るため、bodyが少しでも異なれば別entryです。個別回答が同じであると保証できる場合に向いた機能です。
一方のprompt cacheは、先頭に共通する文脈を読む計算を再利用するだけです。OpenAIは再利用対象をKV state(中間状態)と説明しており、後ろに置いた利用者の質問には新しい回答を生成します。従って、「類似質問なら前の回答を返したい」という要求をprompt cacheで満たそうとしてはいけません。検索結果や在庫、権限、時刻を含む回答を応答cacheで共有するかは、別途key・TTL・認可で判断します。
prefixを三層にし、動く値を先頭へ置かない
最小構成は、入力を次の順番に固定することです。
- 共通層: versionを付けたdeveloper instruction、安定したtool schema、全利用者共通の参照資料
- 境界層: tenantごとの許可済み規程やrole。更新revisionを明示し、利用者境界をまたいで共有しない
- 可変層: 現在の質問、時刻、個人情報、検索結果、tool結果、セッション固有の状態
先頭の一文字が変わるだけでprefix一致が壊れるproviderがあります。OpenAIも、developer instructionや共有資料を先に置き、timestampやuser固有の内容は後ろへ置くこと、会話履歴を途中で書き換えず追記することを案内しています。toolの名称・説明・schema・順序、出力schema、reasoning設定もcacheを変える要因になり得ます。toolを毎turnで並べ替える、日付をsystem promptへ埋め込む、といった実装はヒット率を落とします。
ただし、cache効率のためにtenantの規程や個人データを「共通層」へ移してはいけません。共有境界は仕様上の同一性ではなく、データの利用目的と認可で決めます。OpenAIではcache keyを利用者・顧客別の説明可能な計測単位に分けられ、同社はcache hitを観測して他者の文脈を推測する試行を抑える用途も挙げています。
provider差は抽象化し過ぎず、対応表にする
同じ「cache」でも制御面は異なります。OpenAIの対応modelでは明示的なbreakpointと最小TTLを設定でき、cached_tokensとcache_write_tokensで確認できます。Anthropicはcache_controlでprefixを指定し、既定のTTLは5分、1時間TTLもあります。Google Geminiは2.5以降でimplicit cachingを既定有効にし、共通内容を先頭に置くこと、usage.total_cached_tokensの確認を案内しています。Interactions APIではexplicit cache objectを使えないため、API選定にも影響します。
Amazon Bedrockもimplicitとexplicitの両方式を提供しますが、対応するmodelとAPI、checkpointの最小token数、TTLは組み合わせごとに異なり、同じpromptを繰り返してもhitは保証されません。providerを抽象化する場合でも、実際に返るcache usage fieldを確認して初めて再利用と判定します。
この差を一つの「cache=true」へ隠すと、provider変更時にヒット条件、保持、費用、計測項目が失われます。アプリ側にはcontext_revision、tenant_scope、toolset_revision、cache_modeを残し、provider adapterには「何を固定したか」「どのusage fieldを読むか」を明示します。model切替時は、品質評価だけでなくcache hit率と初回tokenまでの時間も同時に比較します。
TTLは性能設定であると同時に、保持の確認点
短いTTLでは間欠的な業務利用でhitしません。長いTTLではcache write費用や保持条件が変わることがあります。OpenAIはGPT-5.6以降で30分の最小TTLを示し、model・組織の保持方針を確認するよう案内しています。Anthropicは5分TTLを利用ごとに更新し、長い間隔のfollow-upには1時間TTLを案内します。Geminiでは、implicit cachingの最小入力token数がmodelごとに異なります。
ここで「長くすれば速い」とは限りません。低頻度の問い合わせではcache writeがreadを上回り、短い共通promptならcache条件に届かないことがあります。OpenAIはcached inputもtokens-per-minute制限に数えると明記しています。速度・費用・rate limitは別の指標です。加えて、providerが保持するKV stateや明示cache objectが自社の保持方針、契約、地域要件と両立するかを、導入前に法務・セキュリティと確認してください。
まずは「効いたか」をリリース判定にする
リリース前後で、request数だけを見ても判断できません。context_revisionとtenant_scopeで集計し、少なくとも「入力tokenに占めるcached token比率」「cache write token」「初回tokenまでの時間」「総入力費用」「cache miss理由」を比較します。個別prompt本文は無制限にログへ残さず、revision、長さ、providerのusage、失敗種別を中心にします。
評価は、共通規程を使う高頻度業務、長文を継続参照する会話、tool定義の多いagentで分けます。ヒット率が低いなら、まずprefixを可視化して動的値の混入を調べます。tokenを水増しして閾値を越える方法は、回答品質と費用を悪化させる場合があるため、実測と評価なしには採用しません。
限界と反証
prompt cacheは出力品質を保証せず、同じ入力でも同じ回答を返す機能でもありません。OpenAIもcacheはoutput generationを変えないと説明しています。また、個別の検索結果や頻繁に変わる事実を含む業務では共通prefixが小さく、効果が限定的です。低頻度のバッチ、短いprompt、厳しいゼロ保持要件では、cacheより入力削減や非同期化の方が単純なことがあります。
導入時の最小チェックリスト
- 共通・tenant・可変の各層に、所有者とrevisionを付けたか
- 利用者固有値、時刻、検索結果を安定prefixの前へ入れていないか
- providerごとのTTL、最小条件、usage field、保持条件を契約と照合したか
- cache hit率、初回tokenまでの時間、費用、品質評価を同じrelease単位で比較するか
一次情報と確認範囲
確認日:2026年9月15日。製品仕様・制度は更新されるため、導入時はリンク先の最新版を再確認してください。海外の制度・職業規範は日本へ直接適用せず、相違点と限界を本文に明記しています。
- OpenAIのprompt cacheは同一先頭prefixのKV stateを再利用し、新しい入力の回答生成は別に行う
- Anthropicはcache_controlでprefixを指定でき、既定5分TTL・1時間TTLとusage内のread/write tokenを示す
- Gemini 2.5以降はimplicit cachingを既定有効とし、共通内容を先頭に置くこととcached tokenのusage確認を案内する
- Cloudflare AI Gatewayの応答cacheは既定でrequest全体の完全一致を基準とし、prompt cacheとは別機能である
- Geminiのexplicit cached contentはTTLを伴い、絶対的なゼロ保持が必要なら使わないという選択肢がある
- Amazon Bedrockのprompt cachingはimplicitとexplicitがあり、model・APIごとに条件が異なり、hitを保証しない