本文
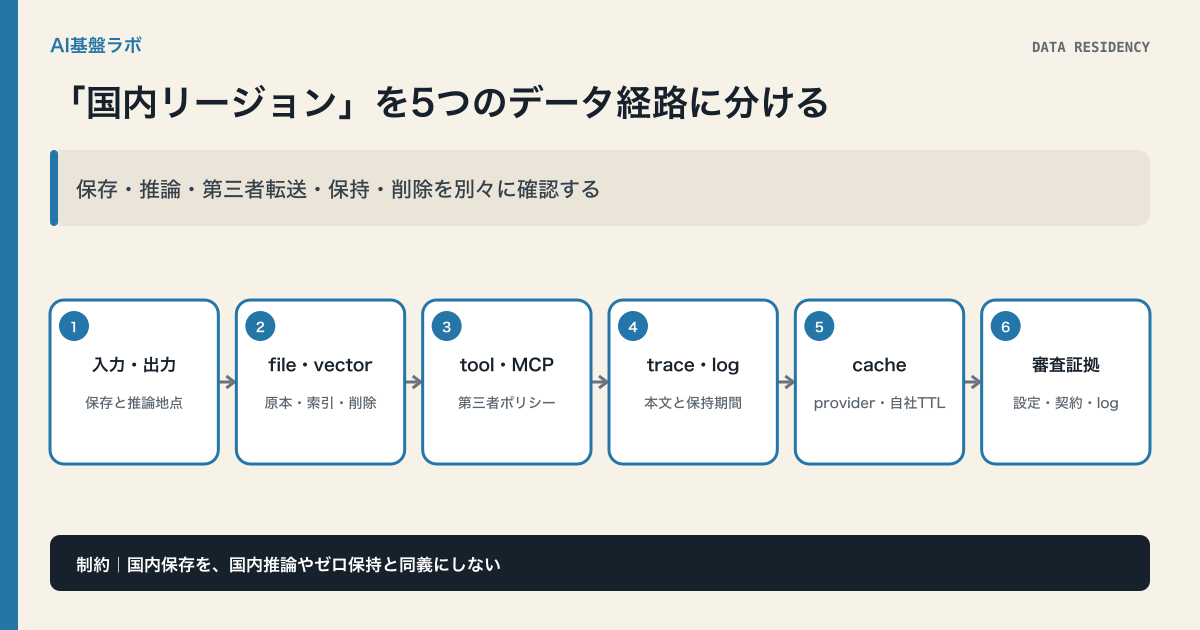
「データを日本に置けますか」という質問に、リージョン名一つで答えるのは危険です。生成AIでは、入力と出力の保存先、推論処理地点、ファイル・ベクトルストア、外部ツール、監視ログ、キャッシュが別々の経路を通ります。国内保存ができても、推論が国内とは限らず、外部ツールへ送ったデータまで同じ条件で守られるとも限りません。
本稿は法的助言ではなく、法務・セキュリティ・実装責任者が同じデータフローを見て判断するための技術的整理です。
最初に五つの経路へ分ける
確認表は次の単位で作ります。
| 経路 | 確認すること |
|---|---|
| prompt / response | 保存先、推論地点、abuse monitoring、保持期間 |
| file / vector | 原本、chunk、embedding、索引の保存先と削除 |
| tool / MCP | 第三者への転送、再委託、接続先の規約 |
| trace / log | 本文・識別子を記録するか、転送先、保持期間 |
| cache | provider側・自社側のTTL、無効化、tenant分離 |
OpenAIの現行Data Controlsは、data residencyをstorageとprocessingに分けています[1]。日本向けendpointは表上でstorage対応、processing非対応とされ、国内保存から国内推論を推定できません。またremote MCP server等の第三者サービスは、OpenAI側のdata residency条件とは別のポリシーに従うと説明されています。
「リージョン」は製品ごとに意味が違う
Microsoft Foundryは、Global、Data Zone、地域別deploymentで処理範囲が異なると説明します[2]。Amazon Bedrockも、単一Region、地理内cross-Region、Globalでrouting範囲が異なり、地理内profileでもsource Region以外へprompt・outputが移動し得ます[3]。AWSはCloudTrailのadditionalEventData.inferenceRegionで処理先を確認する方法も示しています。
したがって設計書には「Tokyo region」のような名称だけでなく、次を記載します。
- 呼出し元endpointとdeployment type
- 処理可能なdestination Region
- 保存先と保持機能
- 利用model・補助機能・tool
- 設定画面、契約、ログによる確認根拠
学習不使用、保存なし、越境なしは別の条件
GoogleのZero Data Retention資料は、学習不使用とcustomer data retentionを分け、abuse monitoringやin-memory cacheの条件を説明しています[4]。同じ資料ではcacheがproject分離され、既定TTLや無効化設定があることも示します。これは「学習に使わない」から「記録が一切ない」を導けない例です。
Google Cloudのdata residency termsにも対象外機能が明記され、GroundingやRAG関連機能を一律に地域内とみなせません[5]。AWSも、modelやretention modeによって保持条件が変わり、cross-Region利用時の保存先が処理先に関係すると説明しています[6]。
技術表を法務判断へ渡す
日本の個人情報保護委員会は、外国にある第三者への個人データ提供について、提供先の制度や相当措置、継続的な実施状況などを確認する枠組みを示しています[7]。どの構成が適法かをエンジニアだけで断定せず、データ種類、利用目的、委託・第三者提供の関係、契約を法務へ渡します。
逆に、個人情報や営業秘密を扱わない低リスク用途へ、最も厳しい地域制約を一律に課す必要もありません。必要な境界をデータ分類で決め、単一Region、地理内routing、Globalのどれを許すかを用途別にします。
完了条件は「国内リージョンを選んだ」ではない
完了条件は、五つの経路それぞれについて、保存、処理、第三者転送、保持、削除、確認根拠が一枚で説明できることです。providerの機能名は変わるため、契約時とmodel変更時に再確認期限を置きます。データ所在地を設定名ではなく、観測可能なデータフローとして扱うことが本番導入の基盤になります。
実装と審査を同じ証拠へ結ぶ
設計表の各行には、公式仕様のURLだけでなく、実際のendpoint、deployment名、region設定、利用中の補助機能、ログで確認できる処理先を結びます。設定画面のスクリーンショットだけでは変更後に追えないため、可能ならIaC、環境別manifest、監査ログのfield名を証拠にします。providerが仕様を変更した時は、影響する経路だけを再審査できます。
障害時の迂回経路にも注意が必要です。通常は地域内modelを使っていても、fallbackがGlobal deploymentなら条件が変わります。性能改善のためにcross-Region profileへ切り替える場合も、source Regionとdestination Regionを記録し、法務・顧客への説明と矛盾しないか確認します。
一次情報と確認範囲
確認日:2026年9月16日。製品仕様・制度は更新されるため、導入時はリンク先の最新版を再確認してください。海外の制度・職業規範は日本へ直接適用せず、相違点と限界を本文に明記しています。